[AI Agent] 2기 2주차: 프롬프트 구성과 모델 최적화
프롬프트의 구성 요소와 Zero-shot·Few-shot, 추론 설정, ReAct를 살펴보고 실패 분석과 평가를 바탕으로 품질·비용·지연을 개선합니다.
1. 프롬프트 요청의 구성
1.1 프롬프트와 요청
프롬프트는 사용자가 입력한 한 문장만을 뜻하지 않습니다.
모델이 응답을 만들 때 참고하는 지시, 사용자 입력, 대화 기록, 예시와 컨텍스트를 함께 가리킵니다.
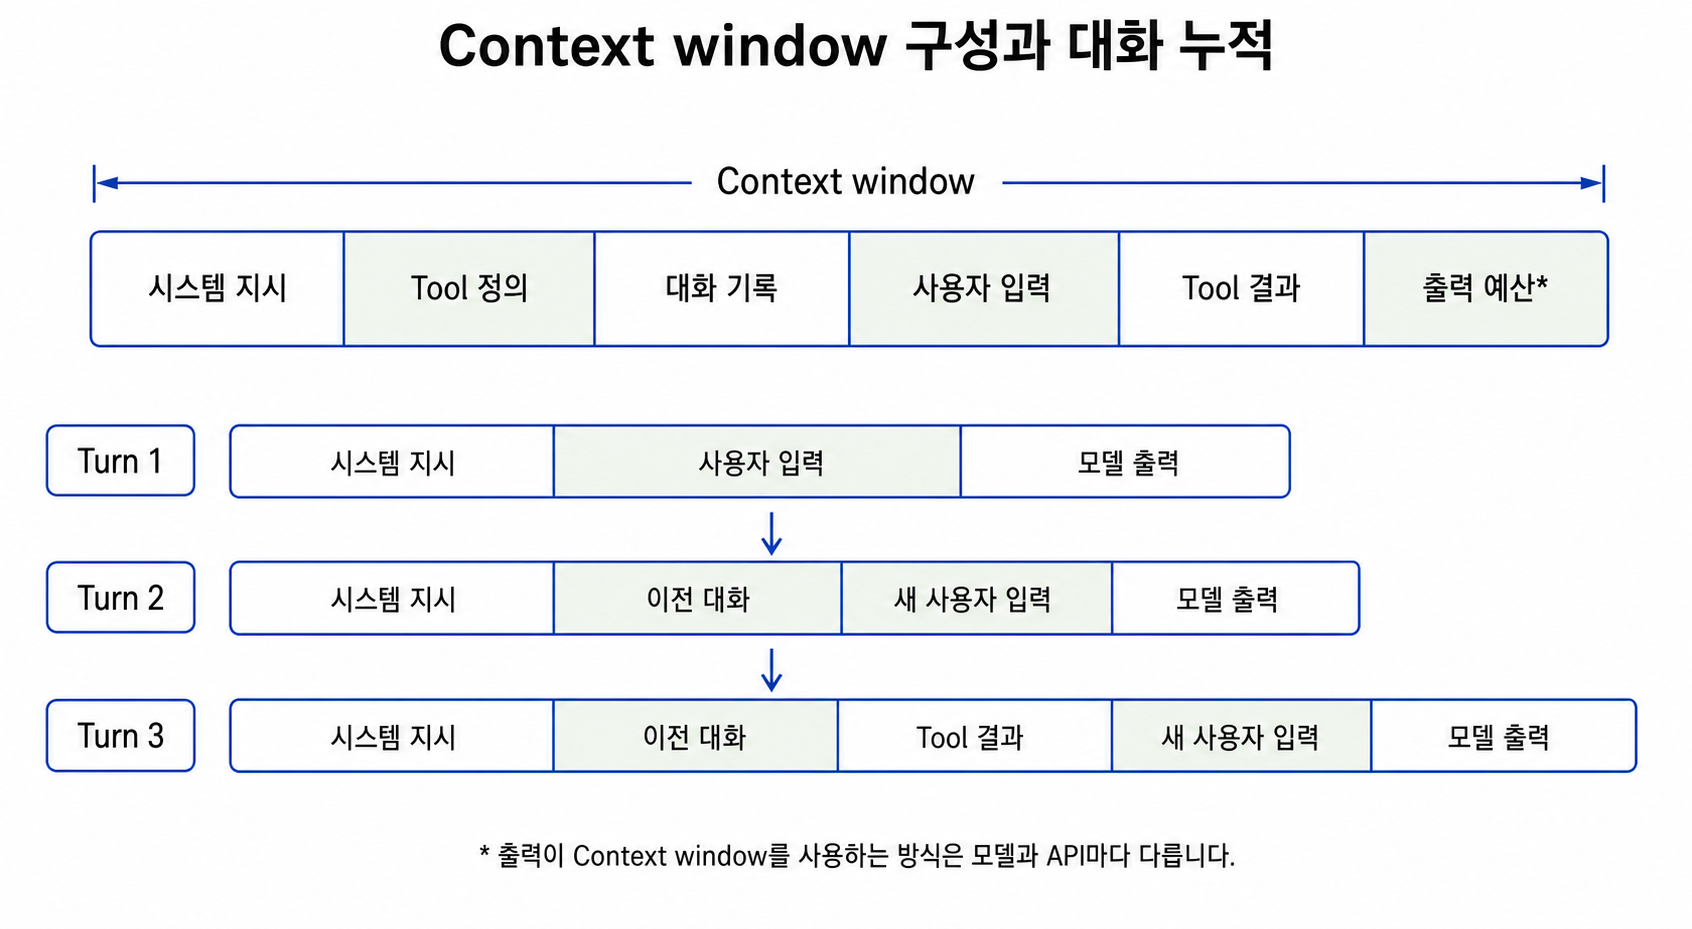
그림처럼 모델은 요청에 포함된 여러 정보를 Context window 안에서 함께 참고합니다.
API 요청은 여기에 사용할 모델, 출력 형식과 생성 설정값을 더해 구성합니다.
API 요청
├─ 모델
├─ 메시지: 지시, 사용자 입력, 대화 기록
├─ 컨텍스트와 예시
├─ 출력 형식
└─ 생성 설정값
1주차 2.5 API 요청과 응답에서는 이 전체 구조를 간단히 살펴봤습니다.
메시지에는 반복되는 업무 규칙과 매번 달라지는 입력을 구분해 배치합니다.
1.2 역할 메시지
역할은 메시지가 대화에서 어떤 기능을 맡는지 구분합니다.
모든 제공자가 같은 이름과 구조를 사용하지는 않지만 표를 보면 역할의 개념을 이해할 수 있습니다.
| 구분 | 담는 내용 | 예시 |
|---|---|---|
| System 또는 Developer | 사용자 요청보다 우선 적용할 행동 원칙과 업무 규칙 | 분류 기준, 금지된 행동, 답변 원칙 |
| User | 이번에 처리할 요청과 입력 데이터 | 고객 문의 한 건 |
| Assistant | 모델이 앞서 생성한 응답이나 대화 예시 | 이전 답변, Few-shot의 기대 출력 |
| Tool result | 외부 기능을 실행하고 돌려받은 결과 | 주문 상태 조회 결과 |
OpenAI처럼 developer 역할을 제공하는 API가 있는가 하면 Anthropic처럼 system prompt를 메시지 목록과 별도 필드로 받는 API도 있습니다.
Tool 결과도 별도의 역할, 콘텐츠 블록 또는 입력 항목으로 표현할 수 있습니다.
실제 필드명, 우선순위와 지원 구조는 사용할 API의 공식 문서에서 확인해야 합니다.
역할을 나누면 반복되는 업무 규칙과 매번 달라지는 입력을 따로 관리하기 쉽습니다.
아래 고객 문의와 출력은 설명용 예시이며 실제 모델의 실행 결과나 성능 측정값은 아닙니다.
[공통 지시]
고객 문의를 정해진 기준에 따라 분류한다.

[사용자 입력]
카드 승인 문자는 왔는데 주문 내역이 없어요.
다만 System이나 Developer에 넣은 문장이 보안 규칙을 대신하지는 않습니다.
외부 문서, 사용자 입력과 Tool 결과에는 신뢰할 수 없는 내용이 들어올 수 있습니다.
권한 검사와 입력·출력 검증은 애플리케이션이 맡아야 합니다.
1.3 역할과 프롬프트 구성 요소는 다른 구분이다
역할은 어디에서 온 메시지인지를 구분하고 프롬프트 구성 요소는 그 안에 어떤 내용을 담는지를 구분합니다.
예를 들어 분류 기준과 출력 형식은 공통 지시에 두고 실제 고객 문의와 현재 주문 상태는 User 메시지나 별도 컨텍스트로 전달할 수 있습니다.
프롬프트를 개선하려면 역할 이름을 정하는 데 그치지 않고 각 역할에 필요한 목표, 기준과 데이터를 제대로 배치해야 합니다.
역할을 나누는 목적과 성능 효과는 구분해야 합니다.
역할 배치의 효과도 같은 평가 데이터로 확인합니다.
2. 프롬프트의 구성 요소
2.1 목표와 작업
먼저 모델이 무엇을 해야 하는지 정의합니다.
고객 문의를 읽고 문의 유형과 담당 조직을 분류한다.도와주세요, 잘 판단하세요, 전문가처럼 답하세요와 같은 표현만으로는 성공 결과를 판단하기 어렵습니다.
작업은 가능하면 입력과 결과가 드러나도록 작성합니다.
입력: 고객 문의 한 건
작업: 문의의 주된 의도를 분류
결과: 문의 유형과 담당 조직
복잡한 업무라면 완료 조건도 함께 둡니다.
현재 문의만으로 주된 의도를 판단할 수 없으면 추측하지 말고
needs_clarification을 true로 반환한다.
목표는 모델에게 행동 방향을 주고 완료 조건은 언제 결과를 확정하거나 멈춰야 하는지 알려줍니다.
2.2 판단 기준과 제약
모델이 알아야 할 업무 규칙을 작성합니다.
- 주문 취소, 상품 옵션 변경, 배송지 변경은 order_change로 분류한다.
- 결제 승인, 이중 결제, 금액 불일치, 결제 수단 변경은 payment_issue로 분류한다.
- 서로 다른 두 유형이 동시에 포함되면 하나를 임의로 고르지 않는다.
- 판단이 어려운 복합 문의는 human_support로 전달한다.
좋은 판단 기준은 용어의 이름과 함께 경계까지 설명합니다.
| 구분 | 부족한 기준 | 경계가 드러나는 기준 |
|---|---|---|
| 배송지 변경 | 배송에 관한 문의 | 출고 전 주소 변경은 order_change |
| 배송 사고 | 배송에 관한 문의 | 지연·분실·오배송은 shipping_issue |
| 복합 문의 | 가장 가까운 유형 선택 | 서로 다른 유형이 함께 있으면 human_support |
제약은 금지 문장을 많이 붙이기보다 실제 실패 가능성이 있거나 서비스에서 반드시 지켜야 하는 경계를 명확히 하는 데 목적이 있습니다.
2.3 지시와 입력 데이터 분리
반복해서 사용하는 업무 규칙과 매 요청마다 달라지는 고객 문의는 분리합니다.
[지시]
고객 문의의 주된 의도를 분류한다.
아래 분류 기준과 출력 형식을 따른다.

[고객 문의]
주소도 바꿔야 하고 결제 수단도 변경하고 싶습니다.
이렇게 나누면 다음 작업이 쉬워집니다.
- 같은 기준으로 여러 문의를 실행
- 업무 규칙과 고객 데이터를 독립적으로 변경
- 프롬프트 버전과 입력 데이터를 따로 기록
- 외부 문서와 사용자 입력을 지시로 오해하지 않도록 구조화
역할 메시지나 구분자는 모델이 각 부분의 역할을 이해하도록 돕습니다.
구분자만으로 입력의 신뢰성이나 실행 권한을 보장하지는 않습니다.
애플리케이션은 사용자 입력, 검색 문서와 Tool 결과를 검증하고 실행 권한을 별도로 검사해야 합니다.
2.4 컨텍스트
컨텍스트는 모델이 이번 요청을 처리할 때 참고할 정보입니다.
고객 문의 분류에서는 다음 정보가 컨텍스트가 될 수 있습니다.
- 문의 유형과 정의
- 주문 처리 단계
- 취소와 변경이 가능한 조건
- 담당 조직과 전달 기준
- 현재 주문 상태
현재 주문 상태처럼 요청마다 달라지는 정보는 모델의 학습 지식이나 프롬프트 표현만으로 확인할 수 없습니다.
예를 들어 고객이 배송지를 바꾸고 싶다고 해도 출고 여부를 모르면 모델은 실제 변경 가능 여부를 알 수 없습니다.
주문 상태를 조회하거나 필요한 정보를 확인하는 절차가 있어야 합니다.
컨텍스트가 많다고 항상 좋은 것도 아닙니다.
관련 없는 정책과 오래된 정보가 섞이면 모델이 잘못된 근거를 사용할 수 있고 비용과 지연도 늘어납니다.
필요한 정보를 충분히 제공한다.
관련 없는 정보는 줄인다.
정보의 출처와 적용 시점을 확인한다.
2.5 예시
설명만으로 경계를 전달하기 어려울 때 입력과 기대 출력을 예시로 제공합니다.
[예시 입력]
배송 완료라고 나오지만 상품을 받지 못했습니다.

[예시 출력]
intent: shipping_issue
route_to: shipping_ops
예시는 모델에게 형식과 판단 패턴을 보여줍니다.
특히 다음 상황에서 도움이 될 수 있습니다.
- 도메인 용어가 일반적인 의미와 다를 때
- 비슷한 유형의 경계를 구분해야 할 때
- 특정한 문체와 출력 형태가 필요할 때
- 실제 실패한 입력의 판단 기준을 보완할 때
예시를 많이 넣는 것 자체가 목표는 아닙니다.
대표성이 없는 예시는 모델을 특정 표현에 치우치게 할 수 있습니다.
평가할 문항의 정답을 예시로 그대로 넣으면 답이 노출되므로 성능이 좋아졌다고 볼 수 없습니다.
예시로 사용할 데이터와 결과를 확인할 평가 데이터는 분리해야 합니다.
2.6 출력 형식
출력 형식은 모델의 결과를 사람이 읽을지, 코드가 사용할지에 따라 달라집니다.
상담원용 설명:
문의 유형과 판단 이유를 두 문장으로 작성한다.
{
"intent": "payment_issue",
"needs_clarification": false,
"route_to": "billing_ops"
}프롬프트에서 출력 형식을 설명하면 요청한 형태를 모델이 이해하는 데 도움이 됩니다.
하지만 JSON으로 답하세요라는 지시만으로 애플리케이션 계약이 보장되지는 않습니다.
API가 Structured Outputs나 Schema 기능을 지원한다면 해당 기능으로 형식을 제어합니다.
프롬프트는 각 필드의 의미와 판단 기준을 설명하고 애플리케이션은 완료 상태와 업무 규칙을 검증합니다.
프롬프트: 무엇을 판단하고 각 값이 무엇을 뜻하는지 설명
Schema: 필드, 자료형과 허용된 구조를 제한
애플리케이션: 응답 상태와 업무상 유효성을 검증
Structured Outputs도 값의 업무상 정확성까지 보장하지는 않습니다.
예를 들어 route_to에 허용된 문자열이 들어 있어도 실제 문의를 잘못된 조직에 배정할 수 있습니다.
거절이나 토큰 한도에 따른 미완료 응답도 성공한 결과와 구분해 처리해야 합니다.
3. 프롬프트 기법과 추론 설정
3.1 Zero-shot
Zero-shot은 작업 지시와 입력을 주되 입력·정답의 예시 쌍은 제공하지 않는 방식입니다.
분류 기준과 출력 형식만 설명해도 요청을 구성할 수 있습니다.
[분류 기준]
배송지 변경은 order_change로 분류한다.
배송 지연·분실·오배송은 shipping_issue로 분류한다.
분류값 하나만 반환한다.

[고객 문의]
배송 완료라고 나오지만 상품을 받지 못했습니다.
분류 기준을 전달했지만 다른 문의의 정답 예시는 넣지 않았으므로 Zero-shot에 해당합니다.
OpenAI의 reasoning 모델 가이드는 간결하고 직접적인 Zero-shot 지시를 먼저 시험하고 필요한 경우 작업과 일치하는 예시를 추가하도록 안내합니다.
3.2 Few-shot
Few-shot은 몇 개의 입력과 기대 출력을 함께 제공하는 방식입니다.
설명만으로 전달하기 어려운 분류 경계나 조직의 판단 규칙을 예시로 보여줄 때 사용합니다.
[예시 1]
입력: 아직 출고 전인데 배송지를 바꾸고 싶습니다.
기대 출력: order_change

[예시 2]
입력: 배송 완료라고 나오지만 상품을 받지 못했습니다.
기대 출력: shipping_issue

[분류할 고객 문의]
예정된 배송일이 지났는데 상품이 도착하지 않았습니다.
두 예시는 배송 관련 표현이 있어도 요청의 목적에 따라 유형이 달라진다는 기준을 보여줍니다.
예시와 업무 지시가 충돌하면 결과가 나빠질 수 있으므로 실제 규칙과 일치하는 사례를 골라야 합니다.
추가 전후의 결과를 비교해 예시가 어떤 실패를 줄였는지 확인합니다.
3.3 Chain-of-Thought와 모델의 추론
Chain-of-Thought(CoT)는 중간 추론 단계를 활용하는 접근입니다.
원 논문은 추론 단계가 포함된 예시를 제공해 산술·상식·기호 추론 성능이 향상됐다고 보고했습니다.
후속 분석에서는 이득이 주로 수학과 논리 문제에 집중됐으며 다른 유형의 작업에서는 더 작았습니다.
Reasoning 모델은 응답을 만들기 전에 내부 추론을 수행합니다.
추론을 제어하는 방식은 모델과 API에 따라 다릅니다.
| 제어 방식 | 의미 | 설정 예시 |
|---|---|---|
| Thinking Budget | 내부 추론에 사용할 토큰 예산 지정 | 이를 지원하는 Claude Extended Thinking 모델의 budget_tokens |
| Reasoning Effort | 추론 노력의 정도 지정 | Claude의 output_config.effort |
| Adaptive Thinking | 요청 난이도에 따라 모델이 추론 여부와 양을 조절 | 지원 모델의 thinking.type: adaptive |
Adaptive Thinking과 Reasoning Effort는 함께 사용할 수 있습니다.
같은 이름의 설정도 모델별 지원 범위가 다르므로 실제 API 문서의 모델 목록과 매개변수를 확인해야 합니다.
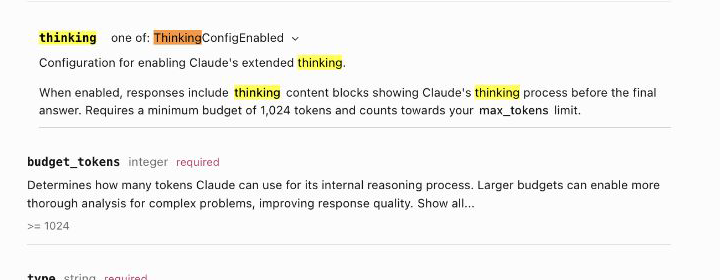
위 화면의 budget_tokens는 이를 지원하는 모델에서 추론 예산을 지정하는 필드입니다.
이 필드가 API 스키마에 표시된다고 모든 Claude 모델에서 사용할 수 있는 것은 아닙니다.
OpenAI는 reasoning 모델에 단계별로 생각하세요라는 지시를 추가할 필요가 없다고 안내합니다.
Anthropic은 모델의 thinking 기능과 설정을 우선 사용하되 thinking을 끈 일부 모델에서는 수동 CoT를 보조 수단으로 설명합니다.
모델이 출력한 reason이나 판단 설명은 검토에 사용할 수 있습니다.
다만 설명이 모델 내부 계산의 완전한 기록은 아니며 답의 정확성도 보증하지는 않습니다.
Anthropic의 연구에서도 모델이 출력한 추론에는 판단에 사용한 단서가 항상 드러나지는 않았습니다.
3.4 ReAct와 Agent의 도구 사용
ReAct는 추론과 행동을 번갈아 수행하고 행동으로 얻은 관찰을 다음 판단에 반영하는 접근입니다.
원 논문은 추론·행동·관찰이 이어지는 작업 예시를 프롬프트에 제공해 외부 정보 조회와 환경 상호작용을 수행했습니다.
| 단계 | 역할 |
|---|---|
| Thought | 현재 정보와 목표를 바탕으로 다음 행동을 판단 |
| Action | 검색·조회 등 수행할 행동을 선택 |
| Observation | 행동으로 얻은 외부 결과를 받아 다음 판단에 사용 |
고객이 배송지 변경 가능 여부를 묻는 상황에 ReAct를 적용한 예시입니다.
이 예시는 동작 설명을 위한 판단 요약이며 모델 내부 추론의 기록이 아닙니다.
고객 요청: 주문 A의 배송지를 바꿀 수 있나요?

판단 요약: 현재 출고 상태를 확인해야 한다.
행동: 주문 A의 상태 조회를 요청한다.
관찰: 조회 결과가 '출고 전'이다.

판단 요약: 제공된 정책에서 출고 전 주문의 변경 조건을 확인한다.
응답: 정책상 변경 가능한 조건과 추가로 필요한 정보를 안내한다.
모델은 사용할 Tool과 인자를 선택합니다.
실행 프로그램이 Tool을 호출하고 결과를 모델에 돌려주면 모델은 추가 조회나 최종 응답을 결정합니다.
Agent는 이런 반복으로 외부 정보를 확인하며 작업을 진행할 수 있습니다.
Zero-shot과 Few-shot은 예시를 제공하는 방식의 구분입니다.
ReAct는 추론과 외부 행동을 연결하는 방식이므로 Few-shot 예시로 ReAct의 작업 흐름을 보여줄 수도 있습니다.
실제 구현에서 Tool 오류, 반복 호출과 중단 조건은 실행 프로그램이 처리해야 하며 도구를 사용했다는 사실만으로 답의 정확성이 보장되지는 않습니다.
기법이나 설정을 바꾼 뒤에는 결과를 확인해야 합니다.
다음 장에서는 실패를 분류하고 변경 전후를 비교하는 방법을 다룹니다.
4. 실패 분석과 개선
4.1 실패 구분
실패 분석은 기대한 행동과 실제 출력을 비교하는 데서 시작합니다.
분류 기준을 잘못 적용했는지, 정보가 부족했는지, 실행 과정에 문제가 있었는지에 따라 바꿀 요소가 달라집니다.
| 실패 유형 | 예시 | 먼저 확인할 부분 |
|---|---|---|
| 작업 오해 | 분류 대신 고객 답변을 작성 | 목표와 작업 |
| 경계 오류 | 배송지 변경을 배송 사고로 분류 | 판단 기준과 예시 |
| 정보 부족 | 출고 상태 없이 변경 가능 여부를 확정 | 입력과 컨텍스트 |
| 복합 요청 오류 | 주소와 결제 수단 변경 중 하나만 선택 | 예외 규칙과 완료 조건 |
| 형식 오류 | 설명을 붙여 JSON 파싱 실패 | 출력 형식과 Schema |
| 의미 오류 | JSON은 맞지만 담당 조직이 틀림 | 업무 기준과 검증 |
| 최신 정보 부족 | 오래된 정책으로 답변 | 데이터 출처와 적용 시점 |
| 권한 오류 | 모델 판단만으로 주문을 취소 | 애플리케이션 권한과 승인 |
| 추론 오류 | 필요한 정보가 있는데 조건을 잘못 결합 | 모델, 추론 설정과 계산 Tool |
| 도구 오류 | 다른 주문을 조회하거나 잘못된 인자를 전달 | Tool 설명, 입력 계약과 인자 검증 |
| 비용·지연 초과 | 정답은 맞지만 운영 기준을 초과 | 모델, 추론 설정, 출력 길이와 호출 수 |
표에서 찾은 실패 유형을 바탕으로 원인 가설을 세웁니다.
실제 개선 여부를 판단하려면 기대값과 비교 조건도 정해야 합니다.
4.2 성공 기준과 비교 데이터
고객 문의 분류에서는 문의 유형, 담당 조직, 정보 부족 처리와 출력 형식을 나누어 확인합니다.
정답이 하나로 정해지지 않는 답변은 정책 준수와 필수 내용처럼 평가할 항목을 명시합니다.
LLM 출력은 실행마다 달라질 수 있지만 이 기준으로 정확도나 규칙 통과율을 측정할 수 있습니다.
기준선은 변경 전 구성으로 실행한 결과입니다.
프롬프트를 바꿀 때는 모델·정책·입력 데이터·생성 설정을 유지합니다.
모델이나 추론 설정을 바꿀 때는 프롬프트와 평가 데이터를 유지합니다.
예시 선정과 규칙 수정에 쓰는 개발 데이터는 최종 검증 데이터와 분리합니다.
정답을 Few-shot 예시에 넣은 문항으로 일반화 성능을 판단하기는 어렵습니다.
최종 검증 결과를 보고 다시 조정했다면 해당 데이터도 개발에 사용한 것이므로 별도의 검증 데이터가 필요합니다.
4.3 원인 가설과 변경
복합 문의 처리 기준이 없는 프롬프트에서 다음 결과가 나왔다고 가정해 보겠습니다.
입력: 주소도 바꿔야 하고 결제 수단도 변경하고 싶습니다.
결과: order_change
출력 형식은 맞지만 복합 문의를 하나의 유형으로 축소했습니다.
복합 요청의 판단 기준이 빠졌다는 가설을 세우고 해당 규칙만 추가해 비교할 수 있습니다.
[추가할 기준]
서로 다른 두 업무 유형이 동시에 포함되면 하나를 임의로 선택하지 않는다.
needs_clarification을 true로 설정하고 human_support로 전달한다.
현재 정보가 빠진 경우에는 조회 절차를 검토해야 합니다.
입력: 이 주문의 배송지를 바꿀 수 있나요?
누락된 정보: 현재 주문의 출고 상태
프롬프트에 변경 가능 조건을 작성해도 현재 주문 상태가 없으면 실제 가능 여부를 판단할 수 없습니다.
주문 조회 데이터나 Tool이 필요합니다.
4.4 개선과 회귀 확인
한 번에 하나의 가설을 검증하면 변경과 결과의 관계를 살펴보기 쉽습니다.
관찰: 복합 문의를 하나의 유형으로 분류했다.
가설: 복합 문의 처리 기준이 없어서 발생했다.
변경: 복합 문의 규칙 한 가지를 추가한다.
확인: 같은 개발 데이터 전체를 다시 실행한다.
새 규칙을 추가한 뒤 복합 문의의 처리가 좋아졌더라도 단일 문의까지 상담원에게 넘길 수 있습니다.
개발 데이터 전체를 같은 기준으로 비교해 회귀를 확인해야 합니다.
기존에 맞던 문항이 변경 후 틀리는지도 살펴봅니다.
비교할 구성에 같은 반복 횟수를 적용해 문항별 성공과 실패를 기록합니다.
한 번의 성공만으로 안정성을 판단하기는 어렵습니다.
프롬프트 버전, 변경 이유, 실행 조건과 결과를 함께 남기면 이후 변경의 비교 기준으로 사용할 수 있습니다.
실패 원인이 현재 정보의 부재나 실행 권한에 있다면 해당 기능을 맡는 구성 요소를 살펴봐야 합니다.
다음 장에서는 모델에 전달할 규칙과 실행 프로그램이 처리할 책임을 구분합니다.
5. 프롬프트의 한계와 시스템 책임
5.1 요구사항별 책임
주문 상태 조회, 실제 주소 변경, 권한 검사에는 외부 데이터와 실행 코드가 필요합니다.
실패 원인이 이런 기능에 있다면 프롬프트 수정과 함께 해당 구성 요소를 보완해야 합니다.
프롬프트는 모델에게 작업과 판단 기준을 전달합니다.
학습된 모델의 파라미터를 요청마다 다시 학습시키지는 않습니다.
프롬프트에 권한 규칙을 적는 것만으로 외부 시스템의 접근 권한이 바뀌지도 않습니다.
| 필요한 요소 | 프롬프트의 역할 | 함께 필요한 구성 요소 |
|---|---|---|
| 목표와 성공 조건 | 수행할 작업과 완료 조건 전달 | Eval로 결과 측정 |
| 도메인 용어와 업무 기준 | 용어·분류 기준·예외 설명 | 정책 문서, Knowledge Base, Rule Engine |
| 현재 정보와 외부 근거 | 어떤 정보가 필요한지 설명 | RAG, Search·API·Database Tool |
| 제약과 예외 처리 | 모델의 행동 규칙 전달 | Guardrail, 애플리케이션 검증, Fallback과 Escalation |
| 출력 계약 | 필드 의미와 판단 기준 설명 | Structured Outputs, Schema 검증과 의미 검증 |
| 실행 권한과 승인 | 허용된 작업과 중단 조건 설명 | Authorization, Approval Gate, Audit Log |
반복적이고 안정된 행동 패턴을 학습시킬 필요가 있다면 Fine-tuning도 검토 대상입니다.
현재 주문 상태처럼 계속 바뀌는 정보는 실행 시점에 조회해야 합니다.
Fine-tuning의 제공 여부와 지원 작업은 사용하는 모델과 서비스에 따라 다릅니다.
5.2 Tool 실행과 권한·승인
서비스의 프롬프트 템플릿은 공통 작업과 규칙을 정의하며 사용자 입력과 조회 결과는 요청마다 동적으로 결합할 수 있습니다.
Tool은 외부 데이터를 조회하거나 계산하고 시스템 상태를 변경하는 실행 수단입니다.
모델은 사용할 Tool과 인자를 반환합니다.
실행 프로그램은 권한과 인자를 검사한 뒤 Tool을 실행하고 결과를 다음 모델 입력에 포함합니다.
모델이 호출을 요청했다는 사실만으로 실제 작업이 완료되지는 않습니다.
프롬프트
→ 배송지 변경 요청을 판별하고 필요한 조건을 전달

주문 조회 Tool
→ 현재 주문이 출고 전인지 확인

실행 프로그램
→ 변경 권한과 승인 조건 검사

주소 변경 Tool
→ 허용된 요청의 배송지를 변경하고 결과 반환
Authorization은 접근 가능한 데이터와 실행 가능한 작업을 제한합니다.
Approval Gate는 특정 작업 전에 사람의 승인을 받는 절차입니다.
Human-in-the-Loop는 사람이 판단·검토·수정·승인에 참여하는 더 넓은 개념입니다.
조회와 변경 작업의 권한, 승인 조건은 서비스 정책으로 정합니다.
예를 들어 주문 조회는 제한된 권한 안에서 자동 실행하고 주소 변경은 승인 후 실행하도록 구성할 수 있습니다.
정보 부족이나 정책 충돌로 처리를 확정할 수 없으면 상담원에게 전달하는 경로가 필요합니다.
5.3 Context Engineering과 Harness
Context Engineering은 모델이 추론 시점에 참고할 컨텍스트를 선별하고 유지하는 일입니다.
지시·도구 설명·외부 데이터·대화 기록·실행 결과가 여기에 포함됩니다.
여러 단계로 동작하는 Agent에서는 무엇을 다시 불러오고 어떤 기록을 요약하며 어떤 상태를 보존할지도 다룹니다.
Harness는 모델의 입력 처리, Tool 호출과 결과 전달 등 Agent의 실행을 관리하는 시스템입니다.
Anthropic은 장기 실행 사례에서 초기 환경 설정, 진행 기록과 검증 절차를 함께 사용해 세션 사이의 작업을 이어가는 방법을 설명합니다.
프롬프트는 이 실행 구조 안에서도 목표와 규칙을 전달합니다.
컨텍스트 선별, Tool 실행, 권한 검사와 결과 검증을 함께 다루면 프롬프트 문구만으로 해결하기 어려운 실패를 각 구성 요소에서 처리할 수 있습니다.
필요한 기능과 검증 절차를 갖춘 뒤에는 같은 품질을 유지하면서 비용과 지연을 줄일 여지가 있는지 비교합니다.
6. 품질 유지와 비용·지연 최적화
6.1 품질 기준을 유지하는 효율화
품질 기준을 충족한 구성도 모델·추론 설정·출력 길이·컨텍스트 양에 따라 비용과 지연이 달라집니다.
Anthropic의 Claude Opus 5 가이드는 effort를 낮춰 시험하되 자체 평가에서 품질이 유지되는 범위까지 조절하도록 안내합니다.
추론량과 최종 응답 길이를 구분해서 조절해야 합니다.
| 변경할 요소 | 비교 방법 | 함께 확인할 실패 |
|---|---|---|
| 모델 | 프롬프트와 데이터를 유지하고 다른 모델 실행 | 경계 사례와 업무 규칙 오류 |
| 추론 설정 | 같은 모델에서 지원하는 effort나 budget 변경 | 복합 조건 판단 오류 |
| 출력 길이 | 필요한 필드를 유지하고 설명 분량 조정 | 필수 내용 누락과 미완료 응답 |
| 컨텍스트 | 중복·무관한 정보를 줄여 비교 | 필요한 근거의 누락 |
| 예시 | 중복 예시를 줄이거나 경계 사례로 교체 | 예시가 보완하던 유형의 회귀 |
| 호출 수 | 반복 생성과 집계 횟수 변경 | 안정성과 정답률 하락 |
출력 토큰 한도를 줄이면 응답이 중간에 끊길 수 있습니다.
토큰 한도와 reasoning 토큰의 관계는 API마다 다르므로 정상 완료 여부를 함께 기록해야 합니다.
6.2 모델별 공식 가이드
같은 기법이나 설정도 모델과 버전에 따라 효과와 지원 범위가 다릅니다.
새 모델을 적용할 때는 기존 프롬프트를 기준선으로 실행한 뒤 공식 가이드에서 권장하는 변경을 하나씩 비교합니다.
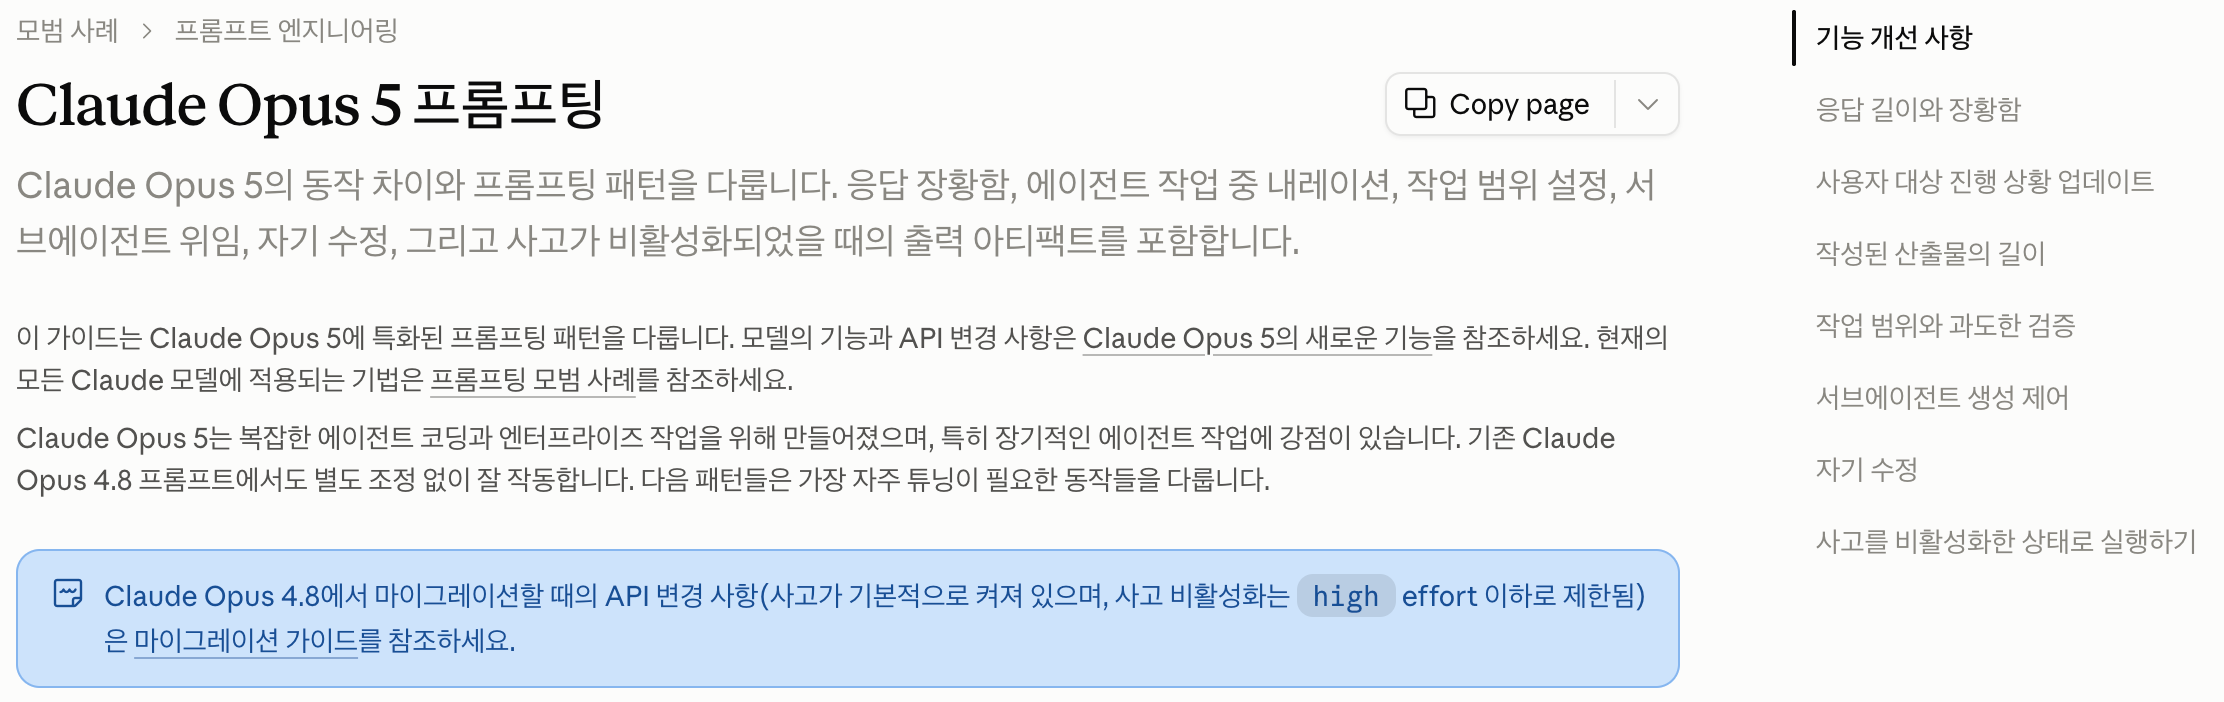
위 가이드는 Claude Opus 5에서 응답 길이, 진행 상황 설명, 작업 범위와 Subagent 위임 등을 조정하는 방법을 다룹니다.
모델별 가이드는 해당 모델을 위한 자료이며 다른 모델에도 같은 효과가 난다는 근거는 아닙니다.
| 대상 | 확인할 내용 |
|---|---|
| OpenAI reasoning 모델 | 목표·제약·예시와 reasoning prompting |
| Anthropic Claude | 모델별 thinking 지원과 지시·예시 구성 |
| Anthropic Claude Opus 5 | effort, 응답 길이와 작업 범위 |
| Amazon Nova 2 | 지시·컨텍스트·입력 구성 |
| Google Gemini | 모델별 추론 설정과 응답 처리 |
- OpenAI reasoning 모델: Reasoning best practices
- Anthropic Claude: Prompting best practices
- Anthropic Claude Opus 5: Prompting Claude Opus 5
- Amazon Nova 2: Prompt engineering guide
- Google Gemini: Gemini thinking
7. 참고 자료
- Stanford CS230 8강: Agents, Prompts, and RAG
- OpenAI Responses API: message input
- OpenAI Model optimization
- OpenAI Model guidance
- OpenAI Reasoning best practices
- Anthropic Prompt engineering overview
- Anthropic Prompting best practices
- Anthropic Effective context engineering for AI agents
- Google Prompt design strategies
- Google What’s new in Gemini 3.5 Flash
- Amazon Bedrock Extended thinking
- Amazon Bedrock Adaptive thinking
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
- To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoning
- Self-Consistency Improves Chain of Thought Reasoning in Language Models
- Anthropic Define success criteria and build evaluations
- Anthropic Demystifying evals for AI agents
- OpenAI Structured model outputs
- Anthropic Reasoning models don’t always say what they think
- Anthropic Effective harnesses for long-running agents
- ReAct: Synergizing Reasoning and Acting in Language Models
- ReAct 프로젝트