[AI Agent] 2기 5주차: Advanced RAG의 개선 효과 해석하기
Hybrid Search와 Re-ranking을 각각 적용한 결과를 기준선과 비교해 검색 순위, 전달된 근거, 최종 답변이 어떻게 달라지는지 설명합니다.
1. 검색 순위가 올랐는데 답변은 왜 그대로일까?
필요한 문단이 검색 결과 7위에서 2위로 올라왔다고 가정해 보겠습니다. 생성 모델에 상위 3개 문단을 보내는 구성이라면 이제 그 문단을 읽을 기회가 생깁니다.
그런데 문단 끝의 예외 조건이 입력 길이 제한에 걸려 잘렸다면 답변은 여전히 틀릴 수 있습니다. 검색 순위와 사용자가 받은 답변은 각각 확인해야 합니다.
기준선은 기존 RAG입니다. 개선 A는 기준선에 첫 번째 기법만, 개선 B는 같은 기준선에 두 번째 기법만 적용한 구성입니다.
각 기법을 고른 이유는 기준선에서 관찰한 문제, 그 기법이 바꾸는 단계, 실제로 달라진 기록을 연결해 설명할 수 있습니다.
아래에서는 짧은 Python 문서 검색 사례로 이 흐름을 따라갑니다.
2. Advanced RAG가 바꾸는 단계
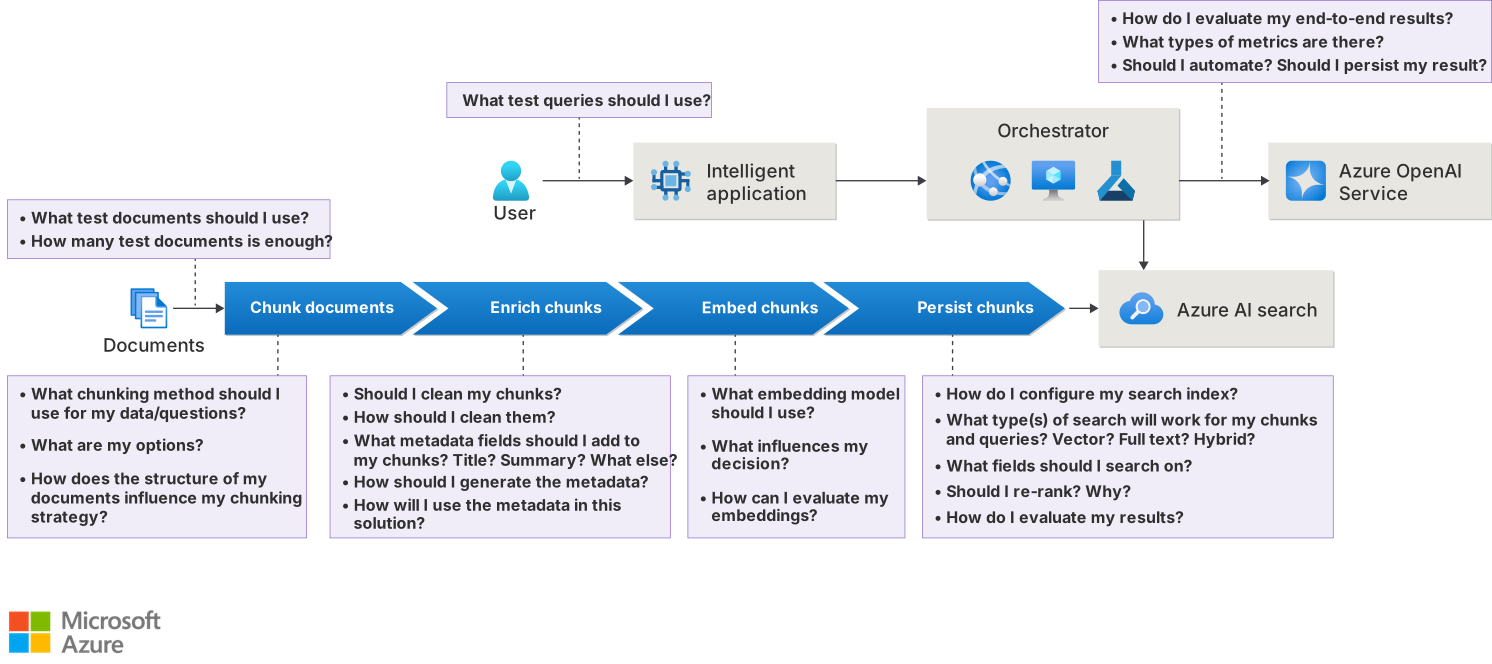
기본 RAG는 질문으로 문서 조각(청크)을 검색하고, 선택한 청크로 컨텍스트를 구성한 뒤 모델이 답변을 생성합니다.
Advanced RAG에서는 이 과정에서 발견한 문제에 맞춰 문서 분할, 질의 처리, 후보 검색, 순위 결정, 컨텍스트 구성 방식을 바꿉니다.
예를 들어 같은 답변 누락이라도 원문의 조건이 청크 경계에서 끊겼을 때와 온전한 청크가 순위에서 밀렸을 때는 바꿀 위치가 다릅니다.
3. 짧은 예시 데이터 — Python 문자열 문서
질문은 “Python 3.9에서 lstrip과 removeprefix 중 문자열 맨 앞의 tmp_를 한 번만 지우는 메서드는 무엇이며, 접두사가 없으면 어떤 값이 나오나요?”입니다.
Python 3.9 문서의 세 절에서 다음 근거를 얻을 수 있습니다.
| 원문 위치 | 확인할 사실 |
|---|---|
내장형 문서 · str.removeprefix | 접두사가 일치하면 한 번 제거하고, 일치하지 않으면 원래 문자열과 같은 값을 반환합니다. |
내장형 문서 · str.lstrip | 인자로 준 문자 집합에 속하는 문자를 왼쪽부터 계속 제거합니다. |
| 3.9 변경 내역 · 새 문자열 메서드 | removeprefix와 removesuffix는 3.9에서 추가됐습니다. |
가령 "tmp_tmp_log".removeprefix("tmp_")의 결과는 "tmp_log"이고 "report".removeprefix("tmp_")의 결과는 "report"입니다.
첫 번째 절에는 질문에 필요한 두 사실이 모두 있습니다. 변경 내역을 찾으면 메서드 이름은 확인할 수 있지만 접두사가 없을 때의 동작까지 설명하기는 어렵습니다.
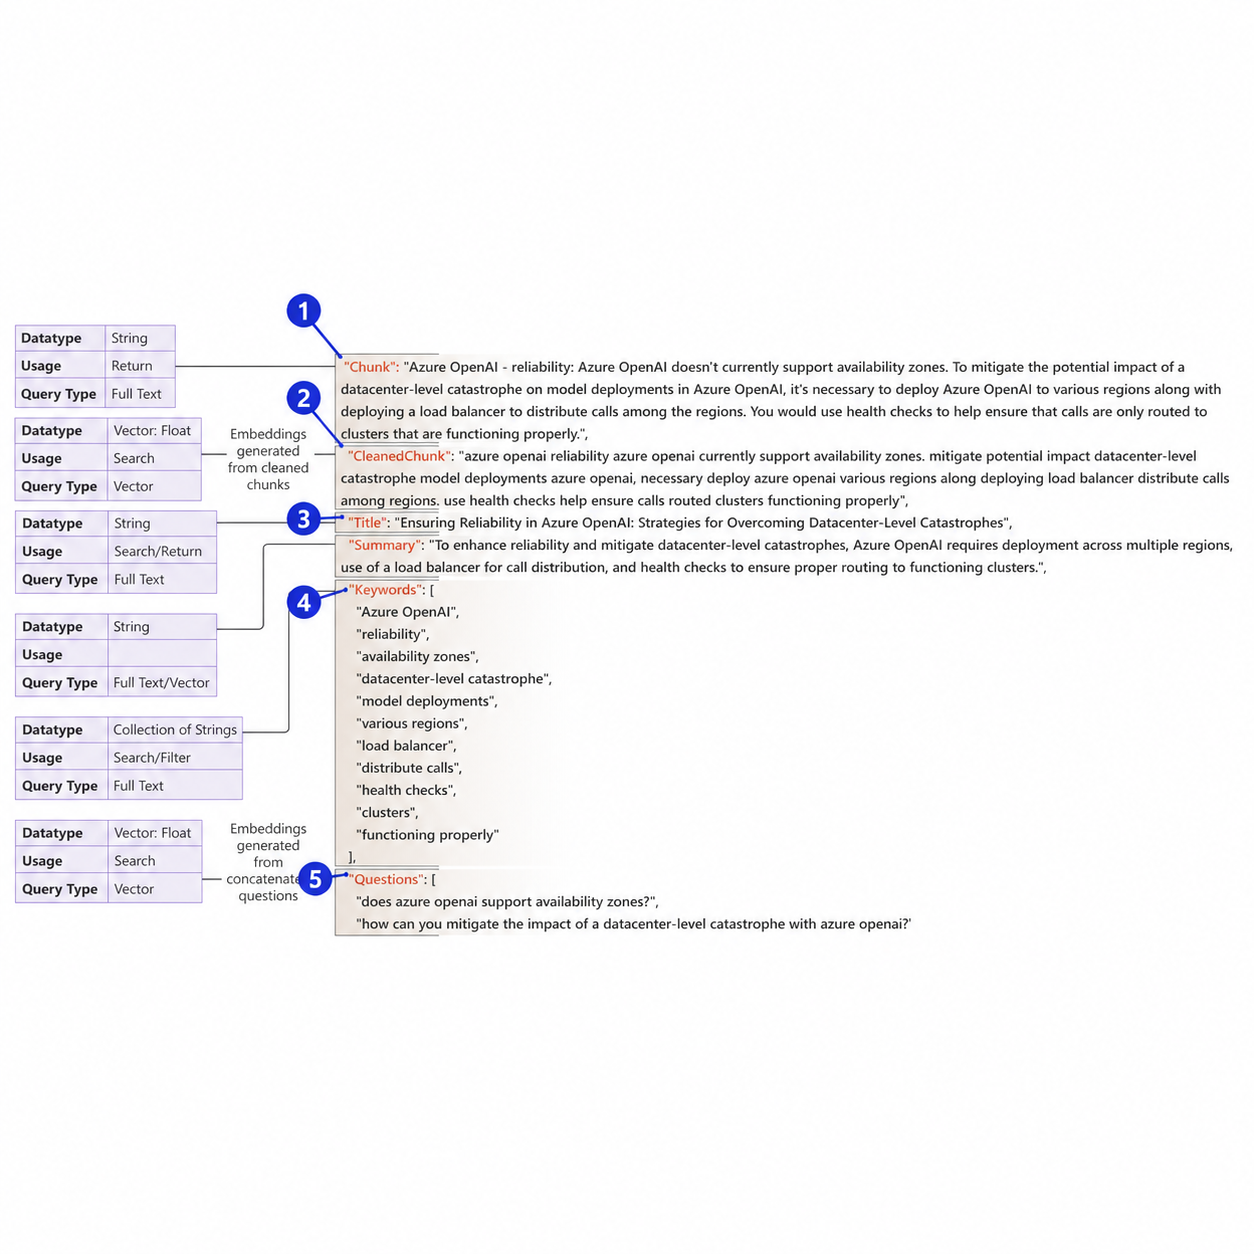
청크에는 본문과 함께 버전, 문서 유형, 절 이름, 원문 링크를 남기면 같은 용어를 언급하는 문단을 구별하기 쉽습니다.
4. 기대 근거가 어디까지 도달했는가
문항 하나를 고르고 기대 근거를 먼저 표시합니다. 예시에서는 메서드 이름과 접두사가 없을 때의 반환값을 각각 추적합니다.
| 확인할 기록 | 관찰 | 개선 가설 |
|---|---|---|
| 원문 → 추출본·청크 | 원문에는 반환 조건이 있는데 추출본에서 빠지거나 제목과 본문이 다른 청크로 나뉨 | 추출 방식이나 청크 경계를 점검 |
| 청크 → 1차 후보 | 올바른 청크를 색인했지만 검색 후보에 없음 | 키워드 검색을 결합하거나 검색 질의를 바꿔 후보 확보 |
| 1차 후보 → 최종 순위 | 기대 청크가 후보에는 있지만 전달 대상으로 고른 상위 K개 밖에 있음 | 다른 검색 목록의 순위를 결합하거나 기존 후보를 재정렬 |
| 최종 순위 → 실제 전달 컨텍스트 | 상위 K개에 들었지만 중복 제거·길이 제한으로 반환 조건이 빠짐 | 컨텍스트 선택·조립 방식 점검 |
| 실제 전달 컨텍스트 → 답변 | 두 사실을 모두 전달했지만 답변은 메서드 이름만 설명 | 답변 지시와 생성 결과 점검 |
최종 Top-K에는 선택한 청크의 ID와 순위를, 생성 기록에는 같은 실행에서 모델에 보낸 텍스트를 남깁니다.
후보나 실제 입력을 볼 수 없는 서비스에서는 관찰한 단계까지만 원인을 좁힙니다.
인용된 문단 하나로 전체 생성 입력을 복원할 수는 없습니다.
5. Hybrid Search로 검색 후보 보완하기
질문에 메서드 이름이 직접 등장하면 키워드 검색이 정확한 식별자를 찾는 데 유리합니다.
반대로 “맨 앞의 표시를 한 번만 지운다”처럼 동작만 설명한 질문에서는 의미 검색이 같은 개념을 다른 말로 설명한 문단을 찾는 데 도움이 될 수 있습니다.
Hybrid Search는 두 검색의 후보를 합칩니다. RRF(Reciprocal Rank Fusion)는 각 목록의 순위를 이용해 결합 순위를 정합니다.
키워드 검색은 벡터 검색이 놓친 후보를 추가할 수도 있고, 두 목록에 공통으로 들어 있는 문단의 결합 순위를 바꿀 수도 있습니다.
3절의 질문은 메서드 이름을 직접 언급합니다. A의 가설은 벡터 검색에서 밀린 API 문단이 키워드 목록에서는 높은 순위를 받아 최종 상위 3개에 든다는 것입니다. 두 목록에서 같은 청크 ID의 순위를 기록하면 후보 추가와 순위 상승을 구분할 수 있습니다.
두 검색이 모두 같은 변경 내역만 찾았다면 결합 후에도 빠진 반환 조건은 확보하지 못합니다.
5.1 검색 엔진이 Hybrid Search를 지원하는 경우
Azure AI Search의 최소 요청 형태입니다.
Full-text 질의와 Vector 질의를 같은 요청에 전달하면 검색 서비스가 결과를 결합합니다.
results = search_client.search(
    search_text=query,
    vector_queries=[vector_query],
    top=3,
)vector_query의 후보 수와 결합 후 반환할 top은 같은 값이 아닙니다.
충분한 Vector 후보를 가져온 뒤 최종 반환 수를 따로 정합니다.
제품마다 Hybrid Search의 지원 범위가 다릅니다.
Dense·Sparse Vector, Full-text Search, BM25, RRF와 필터의 지원 여부를 현재 사용하는 제품과 배포 방식에서 확인해야 합니다.
5.2 애플리케이션에서 결과를 결합하는 경우
검색 저장소가 원하는 결합 방식을 지원하지 않으면 두 Retriever를 애플리케이션에서 실행하고 순위를 합칠 수 있습니다.
LangChain의 EnsembleRetriever는 여러 Retriever의 결과를 결합하는 계층입니다.
BM25Retriever.from_documents(...)로 만든 BM25 인덱스는 전달한 문서를 애플리케이션 프로세스에서 사용합니다.
이 구성은 작은 문서군을 설명하는 데 편리하지만 검색 저장소 자체가 Hybrid Search를 제공하는 구조와 같지 않습니다.
문서량이 커지면 메모리, 인덱스 영속화, 재시작 시 재구축과 다중 인스턴스 동기화를 따로 검토해야 합니다.
6. Metadata Filtering으로 검색 범위 좁히기
질문에 버전이나 대상이 명시돼 있고 각 청크에 해당 메타데이터가 있다면 조건에 맞는 청크만 검색할 수 있습니다.
예를 들어 여러 버전의 문서가 있는 인덱스에서 “Python 3.9에서의 동작”을 물었다면 version = "3.9"를 필터 조건으로 사용할 수 있습니다.
필터가 작동하는 위치는 검색 엔진과 설정에 따라 다릅니다. 비교할 때는 필터 전후의 후보 수와 기대 근거의 포함 여부를 확인합니다.
반면 “어느 버전에서 추가됐는가?”라는 질문에서 변경 내역을 검색 대상에서 제외하면 유용한 근거까지 사라집니다.
문서 유형을 정확히 기록해도 질문에서 필터 조건을 잘못 정하면 검색 품질은 낮아집니다.
7. Re-ranking으로 후보 순위 바꾸기
Re-ranking은 1차 검색이 반환한 후보를 질문과 다시 비교해 순서를 바꿉니다.
Cross-encoder는 질문과 후보 본문을 함께 입력받아 관련성을 계산합니다.
후보 안에 비슷한 문단이 많을 때 질문의 세부 조건을 반영할 수 있지만, 후보마다 추가 계산이 필요합니다.
예시에서 메서드 이름만 언급한 변경 내역과 반환 조건까지 설명한 API 문서가 모두 후보에 있다면, API 문서를 최종 Top-K에 올리는 것이 목표입니다.
같은 후보 목록에서 재정렬 전후의 순위를 확인하고 실제 컨텍스트와 답변에도 반환 조건이 남았는지 봅니다. 기대 문단이 1차 후보에 없다면 재정렬만으로는 가져올 수 없습니다.
8. 다른 실패에서 선택할 수 있는 기법
세 기능으로 모든 검색 실패를 해결할 수는 없습니다.
| 관찰한 문제 | 먼저 살펴볼 구성 | 확인할 변화 |
|---|---|---|
| 질문과 문서의 표현이 다름 | Query Rewriting | 바뀐 질의가 기대 근거의 순위를 높이는가 |
| 한 질문이 여러 조건을 포함함 | Query Decomposition | 하위 질문별 근거를 빠짐없이 찾는가 |
| 청크만 읽으면 제목·대상·시점을 알 수 없음 | Parent-child 또는 Contextual Retrieval | 문서 맥락을 보강했을 때 누락이 줄어드는가 |
| 검색된 청크에 불필요한 내용이 많음 | Contextual Compression | 필요한 근거를 유지하면서 전달 토큰이 줄어드는가 |
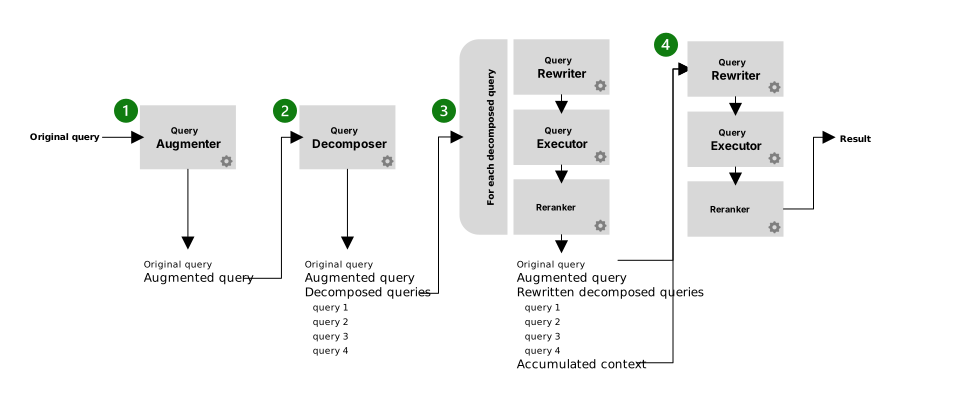
Query Rewriting은 원문 질의를 보존한 상태에서 별도 검색 질의를 만드는 편이 안전합니다.
원문과 변환된 질의를 모두 기록해야 검색 결과가 달라진 이유를 추적할 수 있습니다.
9. 기준선·A·B로 개선 효과 읽기
비교를 시작할 조건
원문과 답변을 사람이 대조해 기존 평가가 중요한 누락을 잡는지 먼저 확인합니다.
예시에서는 ‘메서드 이름이 맞음’과 ‘접두사가 없을 때의 동작을 설명함’을 모두 충족해야 답변을 통과시킵니다.
기준을 보완했다면 저장된 기준선 답변도 새 기준으로 다시 채점합니다. 문항을 바꾸거나 추가했다면 세 구성에서 같은 질문을 실행합니다.
문서 판본, 평가셋, Rubric, 지표, 생성 모델과 프롬프트는 같게 두고 비교할 기법만 바꿉니다.
청킹처럼 기법 자체가 바꾸는 조건은 변경 내역에 남깁니다. 청크 경계가 달라졌다면 같은 원문 절과 필수 사실을 기준으로 근거를 대조합니다.
같은 문항의 세 결과
아래 순위·컨텍스트·응답은 해석 방법을 위한 가상 실행 기록입니다. 원문의 메서드 동작은 3절에서 확인한 사실입니다.
기준선은 벡터 검색 후보 10개에서 상위 3개를 선택합니다. A는 같은 벡터 목록에 키워드 검색 상위 10개를 더해 RRF 순위에서 3개를 고릅니다. B는 기준선의 벡터 후보 10개만 재정렬해 3개를 고릅니다.
세 구성 모두 선택한 청크를 순위대로 이어 붙이고 같은 토큰 한도를 넘는 뒷부분을 자릅니다. 이 예시에서는 API 청크 앞부분에 메서드 설명이, 끝부분에 접두사가 없을 때의 반환 조건이 있다고 가정합니다.
| 구성 | 후보에서 API 청크의 위치 | 최종 상위 3개에서의 위치 | 실제 전달 텍스트 | 답변과 사람 판정 |
|---|---|---|---|---|
| 기준선 | 벡터 7위 | 상위 3개 밖 | 변경 내역에 메서드 이름만 있음 | 이름만 답함 · 조건 누락 |
| A · Hybrid Search | 벡터 7위, 키워드 1위 | 결합 후 2위. 긴 변경 내역이 1위 | API 설명은 들어왔지만 마지막 반환 조건은 잘림 | 이름만 답함 · 조건 누락 |
| B · Re-ranking | 기준선과 같은 벡터 7위 | 재정렬 후 1위. 같은 긴 변경 내역은 2위 | API 청크 전체가 먼저 들어와 반환 조건까지 전달됨 | 메서드와 반환 조건을 모두 답함 · 통과 |
A는 검색 목록을 결합해 이미 있던 근거를 상위 3개에 올렸습니다. 검색 순위는 개선됐지만 고정된 조립 규칙에서 반환 조건이 잘렸으므로 답변 판정은 그대로입니다.
B는 후보 집합을 유지한 채 근거를 첫 번째로 옮겼습니다. 같은 조립 규칙으로도 반환 조건이 남았고, 이 가상 응답에는 그 조건이 반영됐습니다.
이 한 건으로 두 기법의 우열을 정할 수는 없습니다. 컨텍스트 한도나 잘림 규칙이 달라지면 같은 검색 순위에서도 전달 내용이 달라질 수 있습니다.
다른 기법을 골랐다면 표에서 바뀌는 기록도 달라집니다. Query Rewriting은 원래 질문과 검색에 쓴 질의를, Metadata Filtering은 걸린 조건과 제외된 후보를 대조해야 같은 설명이 가능합니다.
적용 여부 판단
대표 문항으로 변화의 이유를 설명한 뒤 같은 평가셋 전체에서 A와 B를 각각 기준선과 비교합니다.
검색 단계에서는 기대 근거 순위와 필수 사실 포함 여부를, 답변 단계에서는 원문에 근거했는지와 질문을 충분히 해결했는지를 봅니다.
관련 청크 전체를 정의할 수 있을 때는 Recall@K도 계산할 수 있습니다. 기존 통과 문항이 실패로 바뀌면 평균이 올랐더라도 회귀로 기록합니다.
기법별로 실행 시간, 검색·모델 호출 수와 확인 가능한 비용을 비교합니다. 평가용 호출은 답변을 만드는 비용과 따로 셉니다.
지표 적용 불가와 호출 오류는 각각 이유와 건수를 적고, 평균 옆에 집계한 문항 수를 표시합니다. 조건마다 집계 대상이 다르면 공통으로 평가한 문항의 결과도 확인합니다.
위 사례만 보면 A에는 컨텍스트 잘림을 점검할 이유가 있고 B에는 기존 성공 문항과 재정렬 지연을 확인할 이유가 있습니다.
최종 판단은 각 기법을 왜 골랐는지, 예상한 단계가 실제로 바뀌었는지, 그 변화가 회귀와 추가 비용을 감수할 만큼 답변에 도움이 됐는지에 따라 유지·수정·제거로 기록합니다.
10. 기법을 조합할 조건
A가 후보 누락을 줄이고 B가 후보 안의 순위를 개선했다면 두 기능을 함께 적용할 가설이 생깁니다.
A+B에서는 B가 받는 후보 목록 자체가 달라질 수 있습니다. 조합의 효과는 별도 실행으로 측정하고 기준선·A·B의 독립 비교 결과와 함께 해석합니다.
참고 자료
- Python 3.9 내장형 — 문자열 메서드
- Python 3.9 변경 내역
- Stanford CS329Z 3강: RAG + Agents
- Design and Develop a RAG Solution on Azure
- Develop a RAG Solution on Azure: Information-Retrieval Phase
- Develop a RAG Solution on Azure: Chunk Enrichment Phase
- Retrieval-Augmented Generation for Large Language Models: A Survey
- Contextual Retrieval
- Azure AI Search: Create a Hybrid Query
- Azure AI Search: RRF Ranking
- Azure AI Search: Vector Query with a Filter
- Weaviate Hybrid Search
- Qdrant Hybrid and Multi-Stage Queries
- Pinecone Hybrid Search
- OpenSearch Hybrid Search
- Chroma Cloud Hybrid Search
- LangChain EnsembleRetriever Reference
- LangChain Community BM25Retriever Reference
- Azure AI Search: Semantic Ranking
- Cohere Rerank Quickstart
- Voyage AI Rerankers
- Qwen3 Reranker
- Jina AI Reranker