[Malware] 고급 정적 분석: PE 구조에서 코드의 동작까지
PE-bear로 확인한 PE 구조와 엔트로피를 해석하고, Packing·Obfuscation과 코드 구조를 연결해 고급 정적 분석의 판단 근거를 정리합니다.
개요
실행 파일의 문자열과 Import 목록은 프로그램의 기능을 추정하는 단서입니다.
하지만 문자열이 숨겨져 있거나 실행 중 API 주소를 찾는 경우에는 이 정보만으로 동작을 파악하기 어렵습니다.
고급 정적 분석에서는 PE 구조와 코드의 흐름을 함께 살펴보며 프로그램이 수행할 수 있는 동작을 추론합니다.
- PE 구조: 헤더와 섹션에서 코드·데이터의 위치, 메모리 배치, 권한을 확인합니다.
- Packing과 Obfuscation: 정적 분석에서 정보가 제한되는 이유와 추가로 확인할 단서를 살펴봅니다.
- 코드 구조: Assembly의 명령과 분기를 연결해 변수, 조건문, 반복문, 함수 호출을 해석합니다.
- 행위 추론: 관찰한 근거를 연결하고 확인한 사실과 추가 검증이 필요한 부분을 구분합니다.
PE 구조는 crackme.exe를 PE-bear로 확인한 화면과 함께 설명합니다.
샘플은 실행하지 않았습니다.
특이한 섹션이나 API 이름만으로 악성 여부를 판단하지 않습니다.
이후 NotPetya의 공개 분석 보고서를 통해 PE 구조와 함수 호출 관계가 행위 해석으로 이어지는 사례를 살펴봅니다.
PE 파일 구조
Windows의 EXE와 DLL은 PE 형식을 사용하는 대표적인 파일입니다.
PE 파일에는 실행할 코드뿐 아니라 Windows가 파일을 메모리에 배치할 때 필요한 정보도 들어 있습니다.
분석자는 이 정보를 읽어 코드가 저장된 위치와 실행을 넘길 진입점을 찾습니다.
일반적인 파일 배치는 다음과 같습니다.
여기서 헤더는 파일을 해석하기 위한 정보를 담는 영역입니다. 섹션은 코드와 데이터를 나누어 저장하는 단위입니다.
DOS Header → DOS Stub → NT Headers → Section Table → 섹션별 코드·데이터- DOS Header와 DOS Stub
- DOS Header의
MZ는 파일 형식을 확인하는 첫 단서입니다. 다만MZ만으로 PE 파일이라고 확정하지는 않습니다. e_lfanew는 PE 서명이 있는 파일 위치를 가리킵니다. 이 값을 저장하는 필드 자체는 파일의0x3C위치에 있습니다.- DOS Stub은 DOS 호환용 프로그램입니다. 일반적인 기본 Stub은 DOS에서 실행할 수 없다는 메시지를 출력합니다.
- DOS Header의
- NT Headers
Signature의PE\0\0으로 PE 서명을 확인합니다.File Header에는 대상 CPU와 섹션 수 같은 파일의 기본 정보가 있습니다.Optional Header에는 실행 형식, 진입점, 메모리 배치 정보가 있습니다. 이름은 Optional이지만 PE 실행 이미지에서는 필수입니다.
- Section Table과 섹션 데이터
- Section Table에는 각 섹션의 이름, 위치, 크기, 권한이 기록됩니다.
- 실제 코드와 데이터는 각 섹션의 파일 위치에서 확인합니다. 섹션 이름만으로 내용과 용도를 확정할 수는 없습니다.
예를 들어 .text는 실행 코드, .rdata는 읽기 전용 데이터, .data는 초기화된 읽기·쓰기 데이터에 흔히 쓰는 이름입니다.
.rsrc에는 아이콘이나 메뉴 같은 리소스가 들어갈 수 있습니다.
이 이름들은 관례이므로 실제 내용과 권한을 함께 확인해야 합니다.
Optional Header에서 확인할 정보
PE-bear의 Optional Hdr 화면에서 crackme.exe의 실행 형식과 진입점을 확인했습니다.
아래 화면의 주소와 크기는 16진수입니다. 본문에서는 이를 구분하기 위해 앞에 0x를 붙였습니다.
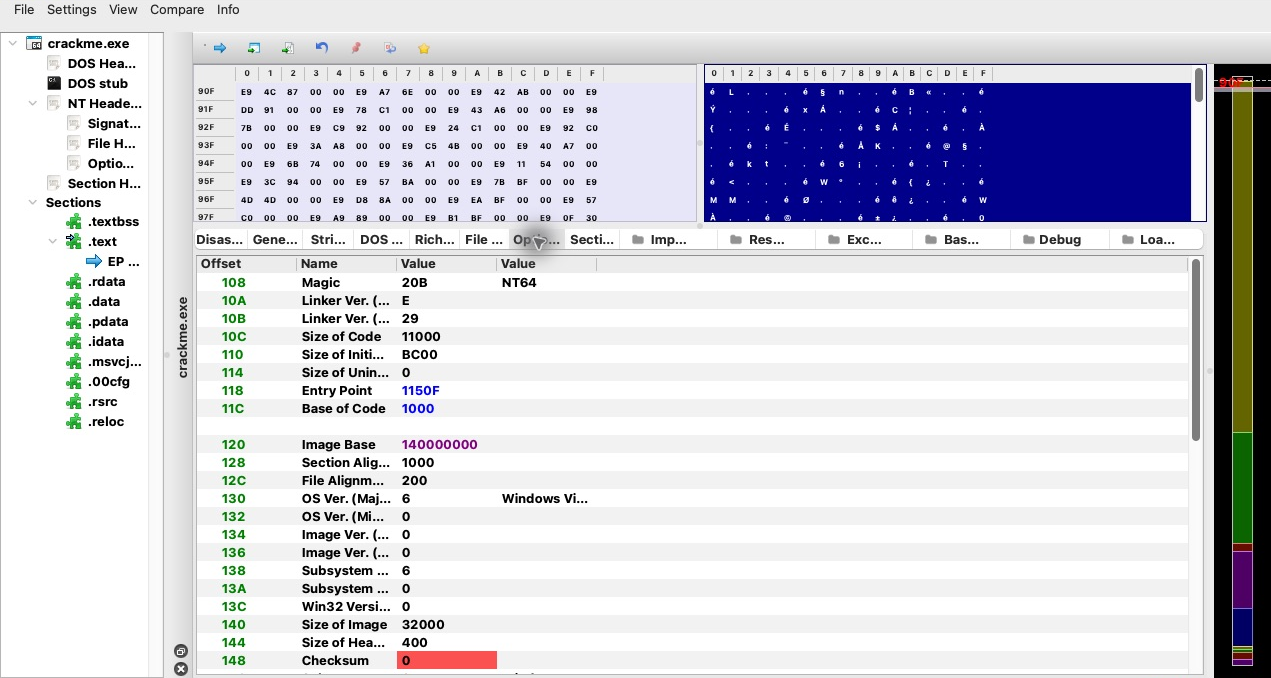
Magic:0x20B- PE32+ 형식이라는 뜻입니다.
0x10B는 PE32를 뜻합니다.
- PE32+ 형식이라는 뜻입니다.
AddressOfEntryPoint:0x1150F- PE-bear에서는
Entry Point로 표시됩니다. 값은 파일 오프셋이 아니라 RVA입니다. - 진입점은 분석을 시작할 단서입니다. C/C++ 소스의
main과 같은 위치라고 가정하지 않습니다.
- PE-bear에서는
ImageBase:0x140000000- 프로그램이 선호하는 메모리 기준 주소입니다. 실행할 때 실제로 배치되는 주소는 달라질 수 있습니다.
SectionAlignment와FileAlignment:0x1000,0x200- 각각 메모리와 파일에서 섹션을 배치하는 정렬 단위입니다. 파일에 저장된 배치와 메모리의 배치가 달라질 수 있음을 보여줍니다.
SizeOfImage와DataDirectorySizeOfImage는 헤더를 포함한 메모리 이미지의 전체 크기입니다. 디스크에 저장된 파일 크기와 구분합니다.DataDirectory는 Import, Export, Resource 같은 정보를 찾아갈 위치와 크기를 제공합니다. 여기서 Import는 외부 DLL에서 가져오는 함수, Export는 다른 프로그램에 제공하는 함수 등의 정보를 뜻합니다.
파일 오프셋·RVA·VA의 차이
같은 코드라도 파일에서 찾을 때와 메모리에서 찾을 때 사용하는 주소가 다릅니다.
파일은 저장된 바이트의 위치를 기준으로 읽습니다. 메모리에서는 로드된 이미지의 배치를 기준으로 읽습니다.
| 구분 | 주소의 기준 | 이번 샘플의 진입점 |
|---|---|---|
| 파일 오프셋 | 파일 시작부터의 바이트 거리 | 0x90F |
| RVA | 메모리에 로드된 이미지의 시작부터의 거리 | 0x1150F |
| VA | 프로세스의 가상 메모리 주소 | 선호 주소에 로드된다면 0x14001150F |
VA는 실제 로드 주소에 RVA를 더해 구합니다.
이번 샘플이 ImageBase에 기록된 선호 주소에 로드된다고 가정하면 다음과 같습니다.
실행해서 확인한 주소는 아닙니다. ASLR로 실제 로드 주소가 달라지면 VA도 달라집니다.
진입점 VA = 실제 로드 주소 + 진입점 RVA
          = 0x140000000 + 0x1150F
          = 0x14001150F
Section Table로 파일 위치 찾기
RVA를 파일 오프셋으로 바꾸려면 해당 RVA가 어느 섹션에 속하는지 먼저 확인합니다.
PE-bear의 Section Hdrs 화면에는 파일 위치와 메모리 위치가 나란히 표시됩니다.
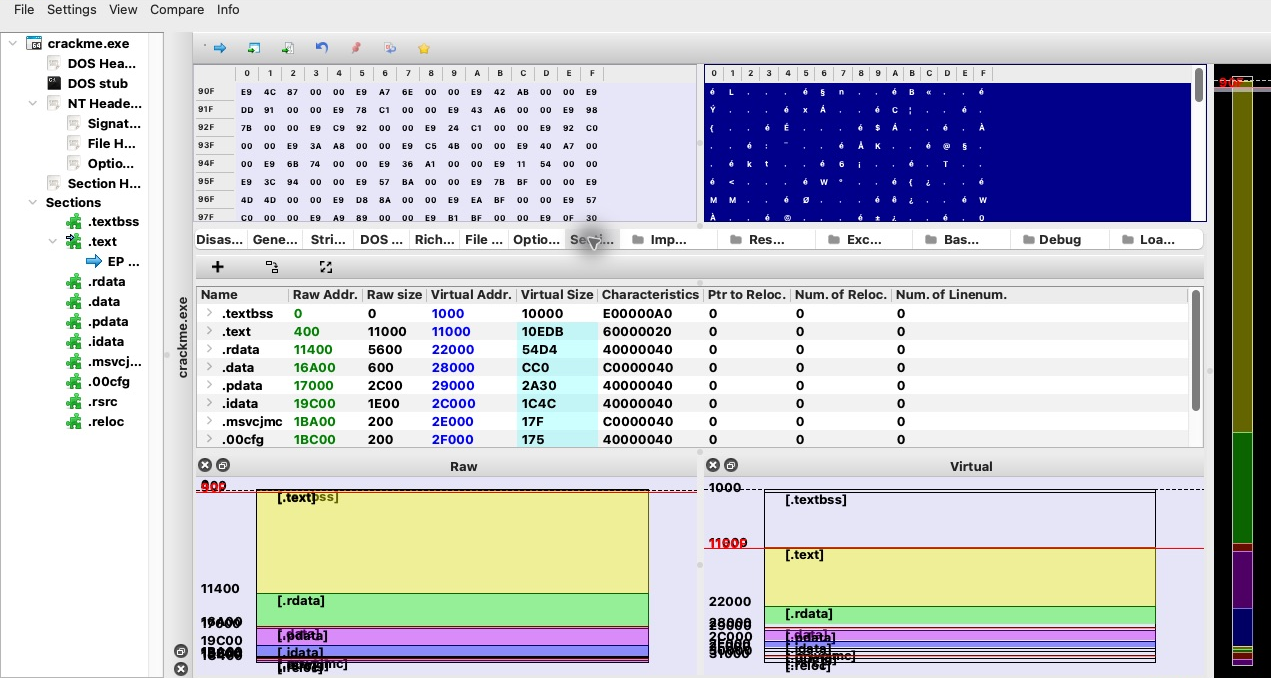
Raw Addr.와Raw size: 섹션이 파일에서 시작하는 오프셋과 파일에 저장된 크기입니다.Virtual Addr.와Virtual Size: 섹션의 시작 RVA와 메모리에서 필요한 크기입니다. 이 화면의Virtual Addr.는 VA가 아닌 RVA입니다.Characteristics: 섹션의 종류와 읽기·쓰기·실행 속성 등을 나타내는 플래그입니다.
진입점 RVA 0x1150F는 .text 섹션에 속합니다.
.text의 시작 RVA는 0x11000이고 파일 시작 오프셋은 0x400입니다.
먼저 섹션 안에서 거리를 구한 뒤 파일의 섹션 시작 위치에 더합니다.
섹션 안에서의 거리 = 0x1150F − 0x11000 = 0x50F
파일 오프셋       = 0x400 + 0x50F = 0x90F
이 계산은 해당 위치에 대응하는 바이트가 파일에 저장되어 있을 때 적용합니다.
예를 들어 .textbss는 Virtual Size가 0x10000이지만 Raw size는 0입니다.
메모리에서 차지할 공간은 있어도 파일에 저장된 섹션 데이터는 없으므로 같은 방식으로 읽을 파일 위치를 찾을 수 없습니다.
여기까지 확인하면 진입점 RVA를 파일의 실제 코드 위치에 연결할 수 있습니다.
다음에는 섹션의 크기와 권한, Import 목록을 함께 살펴보며 어떤 특징을 추가로 조사해야 하는지 판단합니다.
필드 정의와 주소 체계는 Microsoft PE Format을 참고했습니다.
PE-bear 분석 결과 해석
PE 구조에서 특이한 값을 찾았다면 그 값이 무엇을 의미하는지 다른 정보와 연결해야 합니다.
이번에 확인한 crackme.exe는 리버싱 연습용 샘플입니다.
일반적인 배포용 Release 빌드와 다른 특징을 살펴보되 이를 곧바로 악성 행위의 증거로 해석하지 않겠습니다.
분석에서는 섹션 이름·크기·권한, 진입점 위치, Import 목록, 파일에 남은 빌드 정보를 함께 확인합니다.
여기서 빌드는 소스 코드를 실행 파일로 만드는 과정입니다. 디버그 빌드는 개발 중 오류를 찾기 위한 구성입니다. Release 빌드는 배포를 위한 구성입니다.
같은 프로그램도 빌드 설정에 따라 파일 구조와 의존성이 달라질 수 있습니다.
쓰기와 실행이 모두 허용된 섹션
앞의 Section Hdrs 화면에서 .textbss의 Characteristics는 0xE00000A0입니다.
이 값에는 읽기·쓰기·실행을 허용하는 플래그가 모두 포함되어 있습니다.
각 권한의 앞글자를 따서 RWX라고 부릅니다.
- R — Read: 해당 영역의 데이터를 읽을 수 있습니다.
- W — Write: 해당 영역의 내용을 바꿀 수 있습니다.
- X — Execute: 해당 영역을 명령어로 실행할 수 있습니다.
쓰기와 실행이 모두 가능한 영역은 내용을 바꾼 뒤 코드로 실행하는 데 사용될 수 있어 조사할 필요가 있습니다.
하지만 헤더의 권한은 가능한 사용 방식을 보여줄 뿐, 실제로 그런 동작이 일어났다는 뜻은 아닙니다.
이번 .textbss의 Virtual Size는 0x10000, 즉 65,536바이트인 64 KiB입니다.
반면 Raw size는 0이므로 파일에 저장된 섹션 데이터는 없습니다.
따라서 현재 확인한 사실은 파일 데이터가 없는 64 KiB 영역에 RWX 속성이 지정되어 있다는 것입니다. 실행 중 이 영역에 무엇이 쓰이는지는 확인하지 않았습니다.
진입점에서 시작되는 JMP
진입점은 .text 섹션 안에 있습니다. 이 섹션에는 읽기와 실행 권한인 RX가 지정되어 있습니다.
기존 정적 분석에서 확인한 진입점의 첫 명령은 다음과 같습니다.
표시된 주소는 선호 ImageBase를 적용한 주소입니다.
진입점: 0x14001150F
바이트: E9 4C 87 00 00
명령: JMP 0x140019C60JMP는 지정된 위치로 실행 흐름을 옮기는 명령입니다.
이번에는 진입점에서 같은 .text 섹션 안의 다른 위치로 이동합니다.
목적지 함수가 소스 코드의 main인지까지는 확인하지 않았습니다.
- 관찰한 사실: 진입점의 첫 명령이 JMP이고 목적지도
.text안에 있습니다. - 가능한 설명: 다른 함수로 연결하는 짧은 점프 코드일 수 있습니다.
- 추가 확인: 목적지의 명령과 이후 함수 호출을 따라가야 실제 역할을 알 수 있습니다.
Microsoft의 증분 링크 설명에는 jump thunk가 등장합니다. 함수 위치가 바뀌었을 때 연결하는 점프 코드입니다.
증분 링크는 변경된 부분을 반영해 다시 링크하는 방식입니다. 이후 변경을 수용하도록 패딩이라는 여유 공간도 남길 수 있습니다.
따라서 JMP와 패딩은 개발 도구가 만든 흔적일 수도 있습니다. 이 샘플이 실제로 증분 링크 옵션을 사용했는지는 추정입니다.
Import에서 확인한 디버그 런타임
PE-bear의 Imports 화면은 파일에 기록된 외부 DLL 의존성과 가져오는 함수 정보를 보여줍니다.
런타임 라이브러리는 프로그램 실행에 필요한 공통 기능을 제공하는 라이브러리입니다.
Import 목록을 읽으면 프로그램이 사용하는 기능뿐 아니라 어떤 개발 환경에서 만들어졌는지도 추정할 수 있습니다.
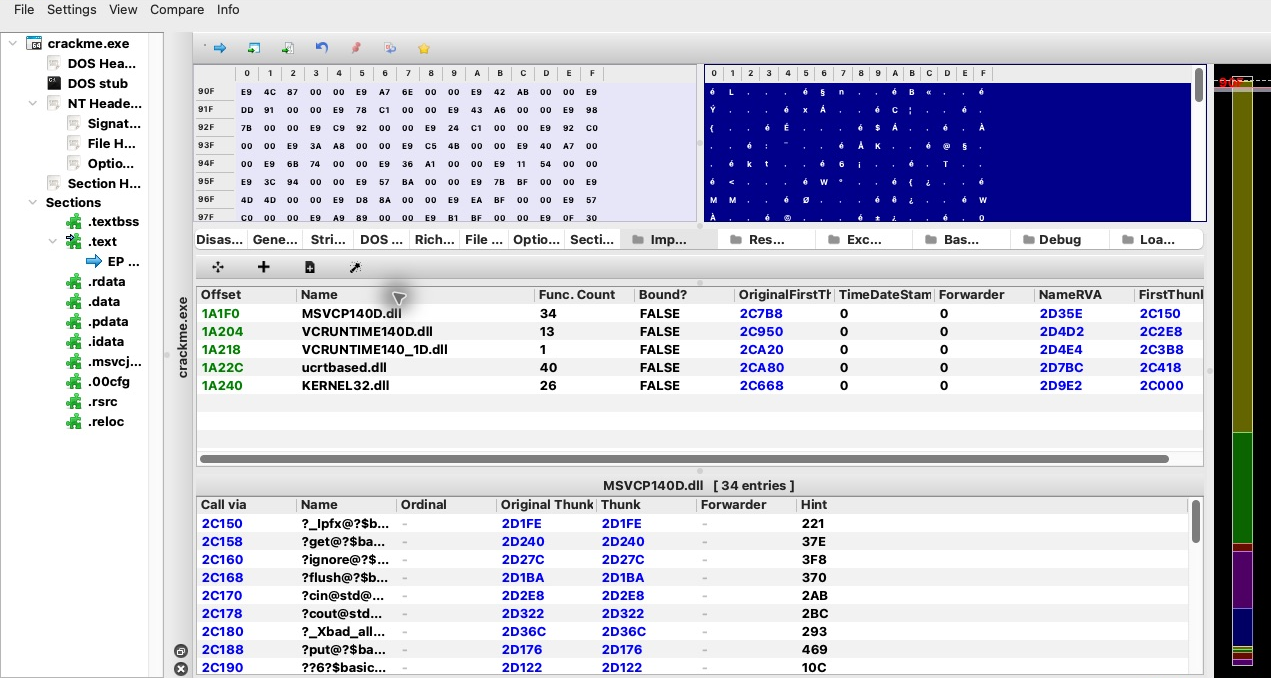
| DLL | Import 항목 수 | 해석 |
|---|---|---|
MSVCP140D.dll | 34 | Microsoft C++ 표준 라이브러리의 디버그 버전 |
VCRUNTIME140D.dll | 13 | Visual C++ 런타임의 디버그 버전 |
VCRUNTIME140_1D.dll | 1 | Visual C++ 런타임의 추가 디버그 구성요소 |
ucrtbased.dll | 40 | Universal C Runtime의 디버그 버전 |
KERNEL32.dll | 26 | Windows의 기본 시스템 기능 |
총 114개의 Import 항목을 확인했습니다.
이 숫자는 실행 중 함수를 호출한 횟수가 아니라 파일에 기록된 항목 수입니다.
디버그 런타임 DLL 4개에 의존한다는 점은 Visual C++ 디버그 빌드라는 해석을 뒷받침합니다.
KERNEL32.dll의 Import에는 IsDebuggerPresent, GetProcAddress, VirtualQuery, TerminateProcess 등이 있습니다.
예를 들어 IsDebuggerPresent는 현재 프로세스가 디버깅 중인지 확인하는 API입니다.
그러나 Import에 있다는 사실만으로 분석을 방해하는 동작이 있다고 결론 내릴 수는 없습니다. 호출 위치와 반환값에 따른 분기를 확인해야 합니다.
엔트로피와 반복되는 바이트
엔트로피는 바이트 값의 분포를 수치로 나타내는 지표입니다.
같은 값이 반복되면 낮아집니다. 여러 값이 고르게 나타나면 높아집니다.
바이트 단위 Shannon 엔트로피의 범위는 0~8 bits/byte입니다.
압축되거나 암호화된 데이터는 높은 엔트로피를 보일 수 있습니다.
다만 압축된 이미지 같은 정상 데이터도 높은 값을 가질 수 있으므로 엔트로피만으로 패킹이나 악성 여부를 판단하지 않습니다.
반대로 패딩이 많이 섞이면 전체 평균이 낮아질 수 있습니다.
아래 값은 PE-bear 화면에서 읽은 값이 아니라 기존 분석에서 pefile로 계산한 결과입니다.
섹션별 계산에는 Raw size 범위의 바이트와 패딩이 포함되었습니다.
- 전체 파일:
3.9220 bits/byte .text섹션:3.7044 bits/byte.idata섹션:4.0083 bits/byte.text안의0xCC비중:52.64%
0xCC는 x86/x64에서 INT3 명령의 인코딩입니다. 디버그 빌드의 패딩으로도 쓰입니다.
이번 .text에서는 같은 바이트가 절반 이상 반복되므로 엔트로피를 해석할 때 이 분포를 고려해야 합니다.
모든 0xCC가 실제 명령으로 실행된다는 뜻은 아닙니다.
앞서 확인한 .textbss에는 파일 바이트가 없으므로 계산할 데이터 자체가 없습니다.
분석 도구가 이 섹션의 엔트로피를 0으로 표시하더라도 이를 데이터가 반복되어 엔트로피가 낮다는 의미로 읽으면 안 됩니다.
여러 단서를 연결한 판단
분석 기록에는 PDB 경로의 일부인 x64\Debug\crackme.pdb도 남아 있습니다.
PDB는 디버깅에 사용하는 심볼 정보 파일입니다. 이번에 확인한 것은 실행 파일에 남은 경로 문자열입니다. PDB 파일 자체를 확보한 것은 아닙니다.
| 확인한 특징 | 함께 고려할 근거 | 현재 판단 |
|---|---|---|
파일 데이터가 없는 RWX .textbss | 디버그 런타임 의존성과 빌드 흔적 | 추가 조사 대상입니다. 실제 용도는 미확인입니다. |
| 디버그 런타임 DLL 4개 | Debug 디렉터리를 포함한 PDB 경로 | Visual C++ 디버그 빌드로 추정합니다. |
진입점 JMP와 많은 0xCC | 증분 링크에서 생길 수 있는 점프와 패딩 | 개발용 빌드의 특징으로 설명할 여지가 있습니다. |
이 샘플에서는 특이한 구조를 악성으로 단정하기보다 디버그 빌드의 흔적과 연결해 해석하는 편이 근거에 맞습니다.
다만 빌드 옵션이나 실행 동작까지 확인한 것은 아닙니다.
다음에는 코드와 데이터의 원래 모습을 숨기는 Packing과 Obfuscation이 정적 분석에 어떤 영향을 주는지 살펴봅니다.
Packing과 Obfuscation
파일에 코드가 들어 있어도 분석 도구에서 원래 명령이나 문자열이 바로 보이지 않을 수 있습니다.
Packing은 실행 파일의 코드·데이터를 압축하거나 변환하는 방식입니다.
Obfuscation은 프로그램의 동작을 유지하면서 코드·데이터의 의미를 파악하기 어렵게 만드는 방식입니다.
| 구분 | 파일에서 달라지는 부분 | 분석할 때 확인할 내용 |
|---|---|---|
| Packing | 원래 코드·데이터가 압축·변환된 형태로 저장됩니다. | 복원 코드와 원래 코드로 제어를 넘기는 지점 |
| Obfuscation | 문자열 표현, 함수 호출, 분기 구조 등이 복잡해집니다. | 값을 복원하거나 계산하는 과정과 실제 실행 경로 |
두 기법은 함께 사용될 수 있습니다.
패킹된 프로그램이 원래 코드를 복원하더라도 그 코드에 난독화가 적용되어 있으면 추가 해석이 필요합니다.
Packing의 실행 흐름
일반적인 ZIP 파일은 사용자가 압축을 풀고 안의 실행 파일을 실행합니다.
실행 파일 패커는 복원용 코드를 함께 넣으므로 패킹된 파일 자체를 실행할 수 있습니다.
압축된 바이트를 CPU가 그대로 실행한다는 뜻은 아닙니다.
압축형 패커의 흐름을 단순화하면 다음과 같습니다.
이는 동작을 설명하기 위한 예시입니다.
앞의 crackme.exe에서 확인한 실행 결과는 아닙니다.
패킹 전: 진입점 → 프로그램의 초기화·주요 로직
패킹 후: 새 진입점 → 복원용 코드 → 메모리에 코드·데이터 복원 → 원래 코드로 제어 이동- UPX: 실행 파일을 압축하는 도구입니다. 패킹과 언패킹을 지원합니다. 저장 공간이나 전송량을 줄이는 용도로도 쓰이므로 UPX 사용 자체가 악성의 증거는 아닙니다.
- Themida: 압축 외에도 코드 보호, 안티디버깅 등 여러 기능을 제공하는 소프트웨어 보호 도구입니다. 모든 패커를 단순한 압축 도구로만 생각하면 이런 차이를 놓치기 쉽습니다.
패킹된 파일을 정적으로 읽으면 원래 프로그램보다 복원용 코드가 먼저 보일 수 있습니다.
이때 진입점의 짧은 코드만으로 전체 기능을 판단하면 뒤에서 복원되는 코드를 놓치게 됩니다.
Packing을 의심할 단서
패킹 여부는 여러 특징을 함께 확인합니다.
각 특징에는 정상적인 빌드나 데이터 구성으로 설명되는 경우도 있습니다.
- 높은 엔트로피: 압축·암호화된 데이터일 수 있습니다. 리소스에 들어 있는 압축 이미지도 고려합니다.
- 적은 Import: 복원이나 동적 로딩에 필요한 일부 API만 파일에 드러날 수 있습니다. 작은 프로그램도 Import가 적을 수 있습니다.
- 특이한 섹션 배치: 낯선 섹션 이름, 큰 메모리 크기와 작은 파일 크기, RWX 권한 등을 살펴봅니다. 앞의 디버그 빌드처럼 다른 설명이 가능한지 확인합니다.
- 진입점 위치와 주변 코드: 복원용 코드로 보이는지 조사합니다. JMP 하나만으로 언패킹 코드라고 단정하지 않습니다.
- 알려진 패커의 흔적: 도구의 탐지 결과를 다른 근거와 비교합니다. 탐지 이름만으로 실제 동작을 확정하지 않습니다.
Detect It Easy는 파일 형식과 컴파일러·패커 등의 흔적을 조사하는 도구입니다.
이번 crackme.exe 분석에는 Detect It Easy의 탐지 결과를 포함하지 않았습니다.
PE-bear에서 관찰한 구조와 별도로 계산한 엔트로피를 근거로 삼았습니다.
Dynamic API Resolution
Import 목록은 프로그램이 사용할 수 있는 모든 API를 보장하지 않습니다.
프로그램은 실행 중 DLL을 불러오고 필요한 함수 주소를 구할 수 있습니다.
이 방식을 Dynamic API Resolution이라고 합니다.
Windows에서 사용하는 대표적인 흐름은 다음과 같습니다.
LoadLibrary로 DLL을 로드하고 해당 모듈의 핸들을 얻습니다.GetProcAddress로 DLL이 제공하는 함수의 주소를 구합니다.- 얻은 주소를 함수 포인터로 사용해 호출합니다. 함수 포인터는 호출할 함수의 주소를 담는 값입니다.
이 방식으로 찾는 대상 함수는 파일의 정적 Import 목록에 나타나지 않을 수 있습니다.
따라서 분석자는 GetProcAddress에 전달하는 이름과 반환된 주소의 사용 위치를 확인합니다.
정상 프로그램도 이 방식을 사용하므로 동적 로딩 자체를 악성 행위로 보지는 않습니다.
API Hashing과 다른 난독화 기법
API Hashing은 함수 이름을 그대로 남기는 대신 해시값으로 식별하는 방식입니다.
일반적으로 후보 이름에서 계산한 값과 저장된 값을 비교해 대상 API를 찾습니다.
해시값을 문자열로 복호화하는 방식과는 다릅니다. 따라서 이름이 복원되는 지점만 찾으면 분석이 막힐 수 있습니다.
- API Hashing: 해시 계산과 비교, 선택된 함수 주소의 사용 위치를 살펴봅니다.
- String Encoding / Encryption: 문자열을 변환된 데이터로 보관합니다. 복원된 값이 어느 함수의 인자로 쓰이는지 확인합니다.
- Control Flow Flattening: 원래의 조건·반복 구조를 상태값과 분기 처리 코드로 바꿉니다. 상태가 바뀌는 조건과 다음 실행 위치를 연결해 읽습니다.
- Dead Code Insertion: 실행되지 않거나 결과에 영향을 주지 않는 코드를 끼워 넣습니다. 코드가 길다는 이유만으로 모든 부분에 같은 의미를 부여하지 않습니다.
- Indirect Calls: 고정된 함수 이름이나 주소 대신 레지스터·메모리에 저장된 주소로 호출합니다. 호출 대상이 정해지는 과정을 추적합니다.
정적 분석에서 이름이 보이지 않으면 값이 만들어지고 사용되는 과정을 따라가야 합니다.
패킹과 난독화의 흔적은 어떤 부분의 분석이 제한되는지 알려주는 단서입니다.
그 단서를 기록한 뒤 코드 구조와 데이터의 흐름을 확인합니다.
Assembly에서 코드 구조 읽기
PE 구조로 조사할 위치를 찾았다면 그 위치의 명령이 어떤 일을 하는지 읽어야 합니다.
Disassembler는 기계어를 Assembly로 보여줍니다. Decompiler는 이를 C와 비슷한 의사코드로 표현합니다.
의사코드는 원래 소스 코드를 그대로 되찾은 결과가 아니라 분석 도구가 추정한 표현입니다.
명령 하나씩 번역하기보다 변수·조건·반복·함수 호출에 해당하는 명령 묶음을 찾으면 흐름을 이해하기 쉽습니다.
아래는 구조를 읽는 기준입니다. 특정 컴파일러가 항상 같은 명령을 만든다는 뜻은 아닙니다.
변수가 저장되는 위치
- Global Variable: 프로그램 전반에서 사용하는 데이터입니다. 초기화 여부와 속성에 따라 파일·메모리의 데이터 영역을 확인합니다.
- Local Variable: 함수 안에서 사용하는 데이터입니다. Stack에 저장되는 경우가 있지만 레지스터에만 있거나 최적화 과정에서 사라질 수도 있습니다.
- 분석할 내용: 값을 읽고 쓰는 주소, 그 값이 살아 있는 범위, 다른 함수에 전달되는 경로를 확인합니다.
Stack은 함수 호출 과정에서 임시 데이터나 복귀 정보 등을 관리하는 메모리 영역입니다.
레지스터는 CPU가 계산과 주소 처리에 사용하는 저장 공간입니다.
따라서 메모리 접근이 보이지 않는다는 이유로 소스 코드에 변수가 없었다고 판단하지 않습니다.
조건문과 분기
조건문에서는 비교 결과가 어느 경로의 실행을 결정하는지 확인합니다.
cmp는 두 값의 비교 결과를 Flags에 반영합니다. test는 비트 AND 결과를 Flags에 반영합니다.
Flags는 연산 결과가 0인지 같은 상태를 기록합니다. 조건부 점프는 해당 상태를 보고 이동 여부를 결정합니다.
비교할 값 준비 → cmp / test → Flags 변화 → 조건부 점프 → 각 경로의 처리예를 들어 cmp 바로 뒤의 je는 두 값이 같을 때 이동하는 경로를 찾는 단서입니다.
다만 코드 사이에 다른 명령이 Flags를 바꾸는지 확인해야 합니다.
최적화로 분기 대신 조건부 이동 명령을 사용할 수도 있으므로 if마다 점프가 하나씩 대응한다고 생각하지 않습니다.
반복문과 되돌아가는 경로
반복문에서는 같은 코드로 다시 돌아가는 경로와 반복을 끝내는 조건을 함께 찾습니다.
앞쪽 주소로 향하는 점프는 중요한 단서지만 그 점프만으로 소스의 for나 while 형태를 확정할 수는 없습니다.
- 초기화: 반복 횟수나 데이터의 시작 위치를 준비합니다.
- 조건 확인: 반복을 계속할지 종료할지 판단합니다.
- 본문 처리: 현재 값이나 데이터에 필요한 작업을 수행합니다.
- 갱신: 카운터나 포인터를 다음 값으로 바꿉니다.
- 재진입: 조건 확인이나 본문으로 돌아갑니다.
실제 명령의 배치는 반복문 종류와 최적화에 따라 달라집니다.
반복을 여러 번 펼치는 최적화가 적용되면 되돌아가는 점프가 줄거나 사라질 수도 있습니다.
함수 호출 전후의 문맥
함수 이름만으로 역할이 분명하지 않을 때는 전달한 인자와 반환값의 사용 방식을 읽습니다.
인자와 반환값을 어느 레지스터나 Stack 위치에 두는지는 CPU와 호출 규약에 따라 달라집니다.
- 호출 전: 전달할 값이 어디서 만들어졌는지 확인합니다.
- 호출 지점:
CALL의 대상과 직접 호출·간접 호출 여부를 구분합니다. - 호출 후: 반환값을 검사하는 분기와 그다음 동작을 확인합니다.
예를 들어 파일 관련 API가 보여도 경로와 접근 방식이 무엇인지에 따라 해석이 달라집니다.
반환값이 실패일 때 종료하는지, 다른 방법으로 재시도하는지도 기능을 이해하는 근거입니다.
Compiler Explorer에서는 짧은 C 코드를 입력하고 생성된 Assembly를 비교할 수 있습니다.
CPU 대상과 컴파일러, 최적화 옵션을 함께 기록하면 나중에 결과가 달라진 이유를 확인하기 쉽습니다.
여기서는 구조를 읽는 기준을 정리했습니다. 별도의 컴파일 비교 실험은 수행하지 않았습니다.
Ghidra에서 근거 연결하기
Ghidra는 Disassembly와 Decompiler 화면을 연결해 코드를 탐색하는 도구입니다.
함수 전체를 처음부터 읽기 어려우면 의미 있는 문자열이나 Import에서 출발해 관련 코드를 좁혀갈 수 있습니다.
아래에서는 탐색 방법을 설명합니다. 이번 샘플을 Ghidra로 추가 분석한 결과는 아닙니다.
| 확인할 항목 | 역할 | 읽을 때의 질문 |
|---|---|---|
| Functions | 분석 도구가 식별한 함수 목록 | 어떤 함수부터 조사할 것인가? |
| Defined Strings | 인식된 문자열 목록 | 경로·메시지·설정값이 어디에 쓰이는가? |
| Imports | 외부 함수 의존성 | 관심 API를 호출하는 코드는 어디인가? |
| XREF | 코드·데이터의 참조 관계 | 누가 이 함수나 값을 참조하는가? |
| Function Graph | 함수 내부의 분기와 연결 | 어떤 조건에서 이 경로가 실행되는가? |
| Decompiler | C와 비슷하게 표현한 코드 | 인자·반환값·조건을 어떻게 해석할 수 있는가? |
XREF는 다른 코드가 해당 함수나 데이터를 참조하는 위치를 찾는 기능입니다.
예를 들어 파일 경로 문자열을 발견했다면 XREF로 사용 위치를 찾아갈 수 있습니다.
그 위치에서 문자열이 파일 API의 인자로 전달되는지 확인하면 문자열과 기능을 연결할 수 있습니다.
- 관심 있는 문자열이나 Import를 찾습니다.
- XREF에서 참조하는 함수를 확인합니다.
- Decompiler에서 인자와 조건을 읽습니다.
- Function Graph와 Disassembly로 실행 경로를 대조합니다.
- 확인한 주소와 근거, 아직 해석하지 못한 부분을 기록합니다.
Decompiler가 붙인 변수 이름과 추정한 자료형이 항상 정확한 것은 아닙니다.
또한 간접 호출은 도구가 모든 참조 관계를 복원하지 못할 수 있습니다.
의사코드에서 내린 해석이 실제 명령과 맞는지 확인하면서 분석 범위를 넓힙니다.
NotPetya의 DLL 복사와 원본 삭제
NotPetya는 전파 기능과 파괴적인 암호화 동작을 가진 악성코드입니다.
여기서는 CrowdStrike의 공개 보고서 중 DLL Loader 부분을 읽고 PE 구조가 행위 해석에 어떻게 쓰이는지 살펴봅니다.
앞의 crackme 실습과 달리 NotPetya 샘플을 직접 분석한 결과는 아닙니다.
보고서의 흐름은 다음과 같습니다.
- 메모리에 로드된 DLL의 복사본을 준비합니다.
- 복사본의 위치에 맞도록 Relocation 관련 주소를 수정합니다.
- 복사본의
+0x94A5에 있는 함수를 호출합니다. - 해당 함수에서
FreeLibrary로 원본 DLL을 해제한 뒤 디스크의 원본 파일을 0으로 덮고 삭제합니다. - 복사본의 Import Table을 수정합니다.
- 복사본의 export ordinal
1을 호출해 전파와 파일·MFT 암호화 동작을 시작합니다.
Relocation은 이미지의 로드 위치가 달라졌을 때 주소를 조정하는 데 필요한 정보입니다.
Export의 ordinal은 외부에서 호출할 항목을 식별하는 번호입니다.
MFT는 NTFS에서 파일과 디렉터리 정보를 관리하는 테이블입니다.
- DLL 복사와 주소 수정: 원본을 해제한 뒤에도 복사본에서 실행을 이어갈 준비로 해석할 수 있습니다.
- 원본 덮어쓰기와 삭제: 디스크에서 원래 DLL을 확보하기 어렵게 만드는 동작입니다.
- Import 수정과 Export 호출: 복사본에서 필요한 함수를 사용할 준비를 마친 뒤 후속 기능으로 제어를 넘깁니다.
이 사례에서는 API 이름 하나보다 동작의 순서가 중요합니다.
원본 파일을 삭제해도 복사본에서 실행이 계속된다는 설명을 통해 파일 삭제와 프로세스 실행 종료를 구분할 수 있습니다.
다만 +0x94A5는 보고서의 분석 대상에 종속된 값입니다. 해당 부분의 실제 Assembly와 전체 호출 관계를 직접 검증하지는 않았습니다.
분석 결과 정리
고급 정적 분석에서는 파일 구조로 조사할 위치를 찾습니다. 코드와 데이터의 관계에서 수행 가능한 동작을 추론합니다.
관찰한 값만 나열하면 나중에 판단 이유를 복원하기 어렵습니다.
분석 기록에는 다음 내용을 함께 남기는 편이 좋습니다.
- 대상: 파일명과 해시, 사용한 도구를 기록해 같은 샘플인지 확인합니다.
- 근거: 주소, 바이트, 섹션 속성, Import, 참조 관계 등 실제로 확인한 정보를 적습니다.
- 해석: 여러 근거가 어떤 동작이나 빌드 특성을 뒷받침하는지 설명합니다.
- 한계: 직접 실행하지 않은 부분과 아직 확인하지 못한 분기·인자를 구분합니다.
- 다음 확인: 가설을 확인하거나 반박하려면 어떤 코드와 동작을 조사해야 하는지 적습니다.
탐지에 활용할 때도 RWX나 API 이름 하나를 곧바로 탐지 조건으로 삼으면 정상 파일을 잘못 분류할 수 있습니다.
정상 사례와 비교하고 여러 근거의 조합이 실제로 구별에 도움이 되는지 검증해야 합니다.
이번 글에서는 PE 구조의 해석과 공개 보고서의 행위 추론까지 다뤘습니다. 탐지 규칙의 성능이나 실행 중 동작을 검증한 것은 아닙니다.
참고 자료
- Microsoft — PE Format
- PE-bear 공식 저장소
- crackmes.one — Beginner Challenge
- Microsoft — /INCREMENTAL
- Microsoft — C runtime과 C++ 표준 라이브러리
- UPX
- Themida
- Detect It Easy
- Microsoft — Using Run-Time Dynamic Linking
- MITRE ATT&CK — Dynamic API Resolution
- Compiler Explorer
- Ghidra 공식 입문 자료
- CrowdStrike — NotPetya Technical Analysis Part II