[Strata] A100 80GB 한 장으로 대형 MoE 모델 구동하기
Strata의 Expert 캐시와 메모리 배치를 살펴보고, A100 80GB 한 장에서 모델과 API 서버를 구동하는 과정을 정리합니다.
개요
GPU는 늘 부족합니다.
사내에서 대형 모델을 시험하거나 운용할 때마다 GPU 자원 배치부터 고민했는데요.
그러던 중 Strata가 Qwen3.8-Flash-Next 대형 모델을 GPU 한 장에서 구동할 수 있다는 소개를 보고 A100 80GB 한 장으로 설치해봤습니다.
Strata가 처리량(TPS)을 확보하기 위해 사용하는 실행 구조를 간단하게 정리했습니다.
- 양자화와 메모리 배치
- Strata는 양자화된 모델을 사용합니다. GPU와 CPU, RAM에 계산과 가중치를 나눠 배치합니다.
- 가중치를 작게 저장하는 방법과 어디에서 계산할지를 구분해 살펴볼 필요가 있습니다.
- Expert 선택과 GPU 캐시
- 모델이 실행할 Expert를 고르는 과정과 Strata가 GPU에 남길 Expert를 고르는 과정이 궁금했습니다.
- 두 선택이 입력과 사용량에 따라 어떻게 달라지는지 살펴봅니다.
- 설치와 API 서버 기동
- v0.1.40.1을 기준으로 구축 과정을 정리합니다.
- 설치 중 필요했던 환경 조건과 서버 연결 방법을 함께 다룹니다.
이 글에서는 Strata의 구조를 살펴본 뒤 A100 80GB 한 장에 설치하고 API 서버를 기동한 과정을 설명합니다.
응답 품질과 처리 속도는 후속 테스트에서 확인해보겠습니다.
Strata의 역할
Strata는 Qwen3.8-Flash-Next 계열 모델을 로컬에서 실행하는 오픈소스 프로젝트입니다.
모델을 계산하는 추론 엔진과 클라이언트의 요청을 받는 HTTP API 서버를 함께 제공합니다.
- 지원 모델
- Qwen3.8-Flash-Next의 양자화 모델과 일부 파생 모델을 지원합니다. 이번 구축에서는 원본 모델의 IQ3_S 양자화 버전을 사용했습니다.
- 공식 모델 카드에서 언어 모델의 규모는 125B입니다. 토큰 계산 시 활성화되는 파라미터는 약 6B입니다.
- MoE 구조
- Expert는 별도의 가중치를 가진 신경망 계산 블록입니다. MoE는 여러 Expert 중 입력에 따라 일부를 선택해 계산하는 모델 구조입니다.
- 이 모델은 각 MoE 레이어에서 512개의 routed Expert 중 10개를 선택합니다. 별도의 Shared Expert 하나도 함께 계산합니다.
- 추론 엔진
- 입력 토큰을 처리하고 다음 토큰을 계산합니다.
- GPU의 Expert 캐시와 RAM의 가중치를 활용합니다. 가중치의 상주 여부와 실행 조건에 따라 GPU 계산·CPU 계산·PCIe 전송을 조합합니다.
- HTTP API 서버
- 클라이언트의 요청을 추론 엔진으로 전달하고 생성 결과를 응답합니다.
/v1/chat/completions같은 OpenAI 호환 API 경로를 제공합니다. 애플리케이션이나 Jupyter에서 이 서버로 요청할 수 있습니다.
MoE가 토큰마다 계산할 Expert를 고르면 Strata는 그 Expert를 실행할 메모리와 계산 경로를 관리합니다.
가중치 크기를 줄이는 양자화와 이 실행 방식의 관계를 살펴보겠습니다.
양자화와 메모리 배치
양자화와 Strata의 메모리 배치는 함께 적용할 수 있습니다.
가중치를 표현하는 방법, 계산할 Expert, 계산 위치를 나눠 살펴보겠습니다.
- 양자화: 가중치의 저장 크기 줄이기
- 가중치를 더 낮은 비트 수로 표현해 파일 크기와 가중치가 차지하는 메모리를 줄입니다.
- 예를 들어 16비트 값을 4비트로 표현하면 값 자체의 저장 비트 수는 1/4이 됩니다. 실제 양자화 형식에는 스케일 같은 추가 정보가 포함됩니다.
- 원래 가중치를 근사해 표현하므로 양자화 형식에 따라 응답 품질과 처리 속도가 달라질 수 있습니다.
- MoE: 계산할 Expert 선택하기
- 모델의 Router가 토큰과 레이어마다 실행할 Expert를 선택합니다. 현재 토큰에서는 선택된 routed Expert를 계산합니다.
- 다른 토큰에서는 다른 Expert가 선택될 수 있습니다. 그때 사용할 전체 Expert 가중치는 GPU·RAM·디스크 중 어딘가에 보관해야 합니다.
- Strata: 가중치의 배치와 계산 위치 관리하기
- GPU 캐시에 있는 Expert는 GPU에서 계산합니다.
- 캐시에 없는 Expert는 RAM의 가중치로 CPU에서 계산하거나 PCIe를 통해 GPU로 전달해 계산할 수 있습니다.
- Router가 선택한 Expert의 가중치를 사용하면서 실행 조건에 따라 계산 경로를 나눕니다.
- 실행 경로
- CPU offloading과의 관계
- CPU offloading에는 가중치를 RAM에 보관하다가 계산할 때 GPU로 옮기는 방식이 있습니다.
- Strata는 RAM에 있는 Expert 일부를 CPU에서 직접 계산하는 경로도 사용합니다.
- CPU offloading 설명 · Strata의 CPU 계산
이번 구축은 IQ3_S 양자화 모델에 Strata의 실행 전략을 함께 적용한 경우입니다.
GPU 한 장으로 구동하더라도 모델을 보관할 RAM과 디스크 공간이 함께 필요합니다.
CPU·PCIe 경로를 사용하는 구성에서는 CPU 성능과 RAM·PCIe 대역폭도 처리 속도에 영향을 줍니다.
가중치 보관과 Expert 실행
Strata는 모델의 데이터를 여러 장치에 나눠 보관합니다.
보관 위치와 선택한 Expert의 실행 경로를 구분해 살펴보겠습니다.
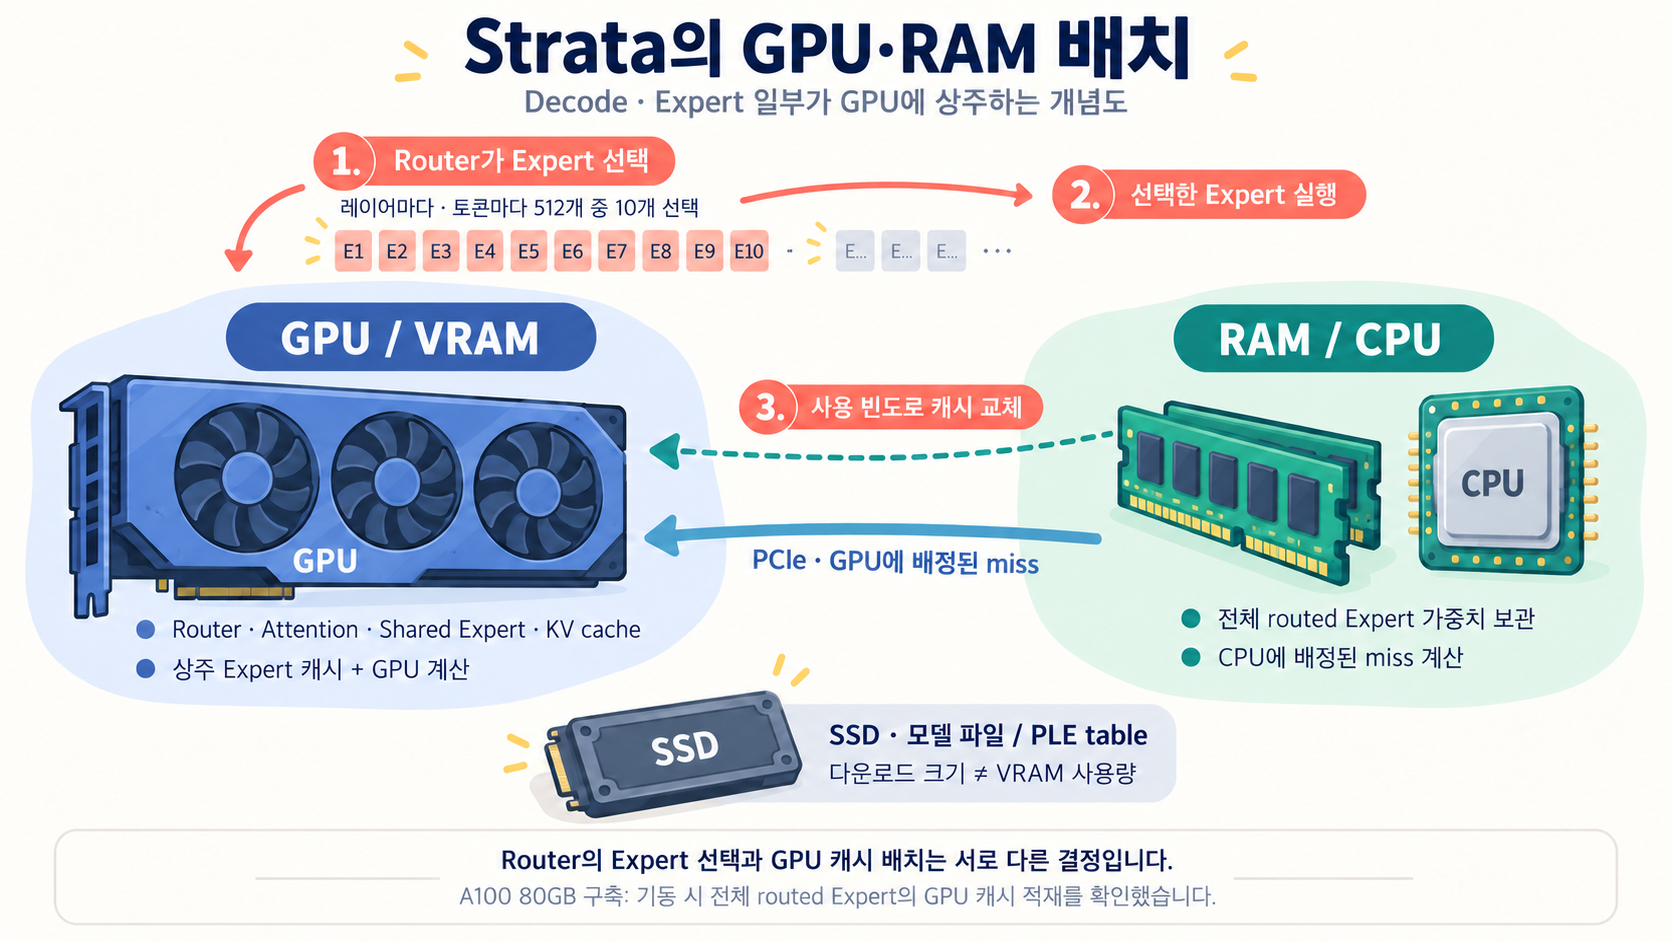
그림은 Expert가 일부만 상주하는 구성을 설명합니다. 이번 A100 80GB 구축에서는 기동 시 전체 routed Expert의 GPU 캐시 적재를 로그로 확인했습니다.
- 보관 위치
- GPU VRAM
- 공통 가중치: Attention·DeltaNet, Router, Shared Expert, 출력층의 가중치를 보관합니다.
- 실행 상태: KV cache는 이전 토큰의 Key·Value를 보관해 재사용합니다. DeltaNet의 recurrent state도 GPU에서 유지합니다.
- Expert 캐시: GPU에 상주하는 routed Expert 가중치의 사본을 둡니다.
- RAM: low-RAM off 설정에서는 전체 routed Expert의 IQ3_S 가중치를 보관합니다.
- SSD: 다운로드한 모델 파일과 PLE lookup table을 보관합니다. 모델을 시작할 때 필요한 가중치를 RAM과 VRAM으로 읽어옵니다.
- GPU VRAM
공통 가중치는 모델이 학습한 고정 파라미터입니다.
KV cache와 DeltaNet state는 요청을 처리하는 동안 유지하는 실행 상태입니다.
PLE lookup table은 짧은 토큰 조합에 대응하는 벡터를 조회하는 테이블입니다.
기본 설정에서는 SSD에 두고 현재 토큰에 필요한 행을 읽습니다.
선택된 Expert의 가중치가 VRAM에 있으면 cache hit입니다.
VRAM에 없으면 cache miss입니다. Strata는 이 상태에 따라 실행 경로를 나눕니다.
- Expert 실행·캐시 교체
- cache hit: VRAM의 가중치로 GPU에서 바로 계산합니다.
- cache miss
- CPU 분담
- GPU에서 입력 벡터와 Expert ID를 CPU로 전달합니다.
- CPU는 RAM의 가중치로 해당 Expert를 계산합니다.
- 계산한 결과 벡터를 GPU로 전달합니다.
- GPU 분담
- RAM의 가중치를 PCIe로 GPU staging 버퍼에 옮깁니다.
- GPU는 이 임시 가중치로 해당 Expert를 계산합니다.
- CPU 분담
- 결과 결합: 선택된 Expert의 출력에 Router의 결합 가중치를 적용해 합산합니다.
- 재사용을 위한 캐시 교체
- 캐시 정책에 따라 GPU에 남길 Expert를 선정합니다.
- RAM의 가중치를 GPU 캐시 슬롯에 복사합니다.
- 복사가 끝나면 상주 정보를 갱신합니다.
CPU에 배정된 Expert의 계산은 GPU의 Expert 계산과 겹쳐 진행할 수 있습니다.
PCIe staging은 현재 계산을 위한 임시 공간입니다. 캐시 교체는 이후에도 가중치를 재사용하기 위한 처리입니다.
RAM은 GPU 캐시에 필요한 Expert 가중치의 공급원입니다.
low-RAM off에서는 GPU에 복사한 뒤에도 RAM의 가중치를 유지합니다.
CPU 계산·GPU staging·캐시 교체가 필요할 때 SSD의 모델 파일을 다시 읽지 않고 이 가중치를 사용합니다.
모든 routed Expert가 GPU에 상주한 Decode에서는 Expert miss를 처리하는 CPU·PCIe 경로를 생략합니다.
다만 --prefill auto는 GPU 캐시의 일부 공간을 입력 처리에 빌릴 수 있습니다.
Prefill이 끝나면 RAM의 가중치로 빌렸던 캐시 슬롯의 Expert를 복구합니다.
이번 IQ3_S 모델의 routed Expert 가중치는 약 50GB입니다.
low-RAM off에서는 이 전체 가중치와 운영체제·다른 프로그램이 사용할 RAM을 함께 확보해야 합니다.
low-RAM 모드에서는 GPU에 상주한 Expert의 RAM 사용량을 줄일 수 있습니다.
GPU의 Expert 캐시 용량은 공통 가중치와 실행 상태, 버퍼가 차지하는 공간을 함께 고려해 정합니다.
KV cache의 필요 용량은 문맥 길이와 동시 요청 수의 영향을 받습니다.
- 구축 조건
- 문맥 길이: 32K
- RAM 보관: low-RAM off
- PCIe 모드: 기본 auto. GPU copy kernel로 staging을 처리합니다.
- PLE 읽기: 기본
--ple-io direct
--ple-io direct는 Linux에서 운영체제의 파일 캐시를 우회하는 읽기 방식입니다.
엔진은 자체 행 캐시에 있는 조회 데이터를 재사용합니다.
모델의 다운로드 크기와 VRAM 사용량은 구분해야 합니다.
- GPU 구성 · KV cache · DeltaNet 상태
- RAM 보관과 GPU 사본 · 모델별 RAM 요구량
- RAM 사본 유지와 가중치 공급 · Prefill 이후 캐시 복구
- 입력 전달 · 결과 회수와 합산
- staging 계산 · auto 모드 · 캐시 상주 정보 갱신
- SSD 역할 · direct I/O · 엔진의 행 캐시
- 전체 Expert 상주 시 실행 경로
토큰마다 달라지는 Expert 선택
각 MoE 레이어의 Router는 현재 토큰에 사용할 routed Expert를 선택합니다.
이 모델은 레이어마다 512개의 routed Expert 중 10개를 사용합니다.
Router 행렬 W_router는 모델이 학습한 레이어별 가중치입니다. 추론 중에는 이 가중치를 고정한 채 사용합니다.
Router가 받는 입력 x는 현재 토큰이 해당 MoE에 들어올 때의 hidden state입니다.
이 벡터에는 토큰과 앞 문맥, 이전 연산의 결과가 반영됩니다.
Expert를 선택하고 출력을 결합하는 과정은 다음과 같습니다.
- Expert별 점수 계산
- Router는
W_router × x로 Expert별 점수인 logit을 계산합니다.
- Router는
- softmax 적용
- 512개 점수를 전체 합이 1인 값
p로 변환합니다.
- 512개 점수를 전체 합이 1인 값
- top-10 선택
p가 큰 Expert 10개의 ID를 선택합니다.- 동점이면 작은 Expert ID를 우선합니다.
- 결합 가중치 재정규화
- 선택된 10개의
p를 그 합으로 나눠 결합 가중치a[e]를 계산합니다. - 구현에서는 분모에
2^-14의 하한을 적용합니다.
- 선택된 10개의
- Expert 출력 합산
- 선택한 Expert의 출력에
a[e]를 곱해 가중합을 구합니다. - Shared Expert 출력에는 별도의 sigmoid gate를 적용합니다. 이 결과를 routed Expert의 가중합에 더합니다.
- 선택한 Expert의 출력에
이 과정을 수식으로 정리하면 아래와 같습니다.
S는 선택된 Expert ID 집합이고 g_shared는 Shared Expert의 gate 값입니다.
z = W_router × x
p[e] = exp(z[e] - max(z)) / Σ_j exp(z[j] - max(z))
S = top_10(p)
a[e] = p[e] / max(Σ_{j∈S} p[j], 2^-14)
y_routed = Σ_{e∈S} a[e] × Expert_e(x)
y_MoE = y_routed + g_shared × SharedExpert(x)
같은 문자 토큰이라도 문맥이나 레이어가 달라지면 입력 x가 달라집니다.
이에 따라 Expert별 점수, 선택 ID, 결합 가중치가 달라질 수 있습니다.
여러 토큰이 같은 Expert 집합을 선택하는 경우도 있습니다.
Router는 현재 입력에 사용할 Expert를 먼저 선택합니다.
Strata는 그 선택 결과를 받아 GPU 상주 여부와 실행 경로를 판단합니다.
GPU 캐시에 남길 Expert를 고르는 기준은 다음 절에서 살펴보겠습니다.
GPU에 남길 Expert의 선택
Router가 선택한 Expert는 GPU 상주 여부와 관계없이 계산해야 합니다.
Strata의 Expert 캐시는 자주 사용할 가중치를 GPU에 미리 보관해 다음 계산에서 재사용하는 공간입니다.
초기 배치는 profile로 정합니다. 일부 Expert만 상주하는 구성에서는 선택 횟수를 집계해 상주 Expert를 바꿀 수 있습니다.
- 초기 배치: Expert profile
- profile은
(레이어, Expert ID)를 우선순위대로 나열한 순위표입니다. --expert-cache auto는 공통 가중치와 실행 상태, 예약 공간을 고려해 캐시 용량을 정합니다.- 확보한 공간을 profile 순서대로 채웁니다. 공간이 충분하면 전체 routed Expert를 올릴 수 있습니다.
- 이 순위표는 Router의 선택 범위를 제한하지 않습니다. 뒤쪽에 있는 Expert도 Router가 선택하면 계산합니다.
- profile은
- 실행 중 집계: 선택 횟수
- Decode의 검증 과정에서 Expert가 선택될 때마다 해당 레이어·Expert의 사용량을 1씩 늘립니다.
- Router의 결합 가중치를 더하는 방식이 아니라 선택 횟수를 세는 방식입니다.
- 나중에 채택되지 않는 후보 토큰의 선택도 포함될 수 있습니다. 최종 출력 토큰만의 통계와는 다릅니다.
Strata는 MTP(Multi-Token Prediction)로 이어질 토큰 후보를 만들고 본 모델로 검증할 수 있습니다.
이때 후보를 묶어 검증하는 단위를 verify round라고 합니다.
기본 캐시 정책은 이 라운드 4회마다 교체를 검토합니다. 출력 토큰 4개마다 교체한다는 뜻은 아닙니다.
- 교체 후보 선정
- GPU에 없는 Expert 중 누적 사용량이 2.0 이상인 것을 후보로 삼습니다.
- 후보는 사용량이 많은 순서로 정렬합니다. 같은 레이어의 상주 Expert는 사용량이 적은 순서로 정렬합니다.
- 교체할 쌍 결정
- 후보의 사용량이 상주 Expert보다 1.5 이상 높을 때 교체 대상으로 묶습니다.
- 같은 레이어 안에서 교체합니다. 레이어별 캐시 슬롯 수를 매번 다시 배분하는 방식은 아닙니다.
- 가중치 교체
- 사용량 차이가 큰 쌍부터 한 번에 최대 96개를 교체합니다.
- 새 가중치를 GPU에 복사한 뒤 상주 표를 갱신합니다. 매번 96개를 반드시 바꾸는 것은 아닙니다.
- 오래된 사용의 영향 줄이기
- 사용량에 0.7을 곱합니다. 이 값은 다음 교체 판단에 사용합니다.
- 반복적으로 줄어들기 때문에 집계된 사용량은 정수가 아닐 수 있습니다.
한 번 선택됐다는 이유로 곧바로 GPU에 올리는 정책은 아닙니다.
최소 사용량과 사용량 차이를 함께 적용해 교체 빈도를 조절합니다.
가중치의 내용은 그대로 두고 GPU에 보관할 사본의 위치를 바꿉니다.
Prefill과 Decode는 토큰을 처리하는 단위도 다릅니다.
같은 Router 선택 원리를 따르더라도 가중치를 공급하는 방식은 구분해 봐야 합니다.
- Prefill: 입력 문맥 처리
- 프롬프트의 여러 토큰을 묶어 처리합니다. 같은 Expert를 선택한 토큰은 모아 GPU에서 계산합니다.
--prefill auto는 Expert 캐시의 일부 공간을 입력 버퍼와 가중치 staging에 빌려 쓸 수 있습니다.- 입력 처리가 끝나면 빌렸던 캐시의 Expert를 복구합니다.
- Decode: 응답 생성
- 토큰을 생성하고 MTP 후보를 검증합니다. 이 과정의 선택 기록으로 캐시 교체를 판단합니다.
- 모든 routed Expert가 상주하면 사용량 집계와 adaptive 교체를 생략합니다.
이번 A100 80GB 구축의 기동 로그는 아래와 같습니다.
strata generate: pre-filled 24576 of 24576 slots from the profile원본 모델은 48개 레이어에 각각 512개의 routed Expert를 둡니다.
24,576 = 48 × 512이므로 전체 routed Expert의 GPU 캐시 적재를 확인할 수 있습니다.
이 전체 상주 상태의 Decode에서는 Expert miss를 처리하는 CPU·PCIe 경로와 adaptive 교체가 필요하지 않습니다.
low-RAM off 구성에서는 RAM의 가중치 사본도 유지합니다.
Prefill은 캐시 공간을 빌릴 수 있으므로 기동 시 전체 상주와 입력 처리 중의 배치는 구분합니다.
- 자동 캐시 용량 계산 · 초기 profile과 GPU 캐시 채우기
- 선택 횟수 집계 · 교체 후보와 기준
- 교체 기본값 · 사용량 감소
- 전체 상주 시 사용량 집계 생략
- Prefill의 캐시 공간 사용 · Expert 복구 구현
구동 결과와 필요한 조건
A100 80GB 한 장에서 Qwen3.8-Flash-Next IQ3_S 모델을 구동했습니다.
Strata API 서버의 Ready와 Docker Jupyter에서의 호출도 확인했습니다.
이 구성을 만드는 데 필요한 엔진과 자료, 실행 옵션을 정리하겠습니다.
| 준비 항목 | 이 글의 구동 구성 |
|---|---|
| Strata | v0.1.40.1 · commit 82f46a8 |
| 모델 | 원본 Qwen3.8-Flash-Next IQ3_S |
| GPU | A100 80GB 한 장 |
| GPU Expert 캐시 | 기동 시 전체 routed Expert 상주 확인 |
| 추론 엔진 | CUDA 12 엔진을 직접 빌드 |
| 빌드 도구 | CUDA Toolkit 12.9의 nvcc · g++ · CMake·Ninja |
| Python | 3.10 이상 · 프로젝트 가상환경 |
| 가중치 보관 | RAM의 전체 routed Expert · SSD의 모델 파일과 lookup table |
아래 설치 예시는 CUDA 12.9 Toolkit으로 Strata의 CUDA 12 엔진을 빌드하는 경로입니다.
실행 환경의 NVIDIA 드라이버는 이 CUDA 런타임과 호환되어야 합니다.
Strata는 이 버전의 CUDA 12 엔진을 실험적 지원으로 안내합니다.
빌드에 사용할 컴파일러는 STRATA_NVCC로 지정합니다.
컴파일러 버전은 nvcc --version으로 확인합니다. nvidia-smi의 CUDA Version은 드라이버의 지원 범위를 나타내는 값입니다.
Toolkit이 없다면 CUDA 12.9의 Linux 설치 가이드에 따라 먼저 준비합니다.
- 모델과 메모리
- IQ3_S: 원본 모델의 양자화 버전입니다. Expert를 제거한 Coder 파생 모델과 구분합니다.
- 문맥 32,768·INT8 KV: 최대 문맥 길이를 32K로 설정합니다. KV cache는 INT8 형식을 사용합니다.
- low-RAM off: 전체 routed Expert 가중치를 RAM에 보관합니다.
- VRAM reserve 2,048 MiB: 자동 Expert 캐시 크기를 정할 때 남겨 둘 여유 공간입니다.
- 요청과 생성
- parallel 1: 한 번에 하나의 요청을 처리합니다. 나머지 요청은 대기열에서 기다립니다.
- 텍스트 API: 텍스트 입력과 응답을 사용하는 구성입니다.
- MTP·CJK draft vocabulary: 한국어 등 CJK 토큰을 포함하는 후보 생성 구성입니다. 후보는 본 모델의 검증을 거칩니다.
- native·Expert profile·자동 캐시·자동 Prefill: 공식 설치기가 실행 설정을 생성합니다.
이 옵션은 다음 절의 설치 명령에 반영합니다.
설치기는 엔진과 모델 자료를 준비하고 서버가 읽을 설정 파일을 만듭니다.
설치와 모델 준비
서버를 기동하려면 엔진, 모델 파일, MTP 자료와 실행 설정이 준비되어야 합니다.
공식 설치기는 사전 점검, 엔진 빌드, 모델 다운로드, MTP 준비 순서로 이 자료를 준비합니다.
아래는 앞 절의 구동 조건을 적용하는 공식 설치기 예시입니다.
설치 경로와 GPU 번호, 포트는 각 환경에 맞춰 지정합니다.
-
자원과 도구 확인
- 사용할 GPU의 메모리와 현재 작업을 확인합니다. 전체 GPU를 사용할 수 있는지도 점검합니다.
- RAM은 Expert 가중치 외에 운영체제와 다른 프로그램이 사용할 여유도 필요합니다.
- IQ3_S의 모델 다운로드 크기는 약 83.6GB입니다. MTP 자료와 빌드 공간이 추가로 필요하므로 SSD의 가용 공간을 함께 확인합니다.
nvidia-smi free -h df -h . python3 --version g++ --version git --version /usr/local/cuda-12.9/bin/nvcc --version -
고정 버전 준비
- 모델과 준비 자료를 저장할 SSD의 디렉터리에서 소스를 받습니다.
- 아래 GPU 번호
0은 예시입니다. 사용할 장치 번호로 바꿉니다.
git clone --depth 1 --branch v0.1.40.1 \
  https://github.com/Niko1221/Strata.git
cd Strata
git rev-parse HEAD

export STRATA_GPU=0
export STRATA_NVCC=/usr/local/cuda-12.9/bin/nvcc
export PATH="$PWD/.venv/bin:$PATH"

sh setup.sh --check --cuda 12 --gpu "$STRATA_GPU"
git rev-parse HEAD의 값은82f46a8c8f475f001ad76d92f58f4a4f8ffb0253입니다.
setup.sh는 Python 가상환경을 준비한 뒤 설치기를 실행합니다. CMake와 Ninja는 이 가상환경의 도구를 우선하도록 설정했습니다. -
엔진 빌드와 모델 준비
- 설치기는 CUDA 12 엔진을 빌드한 뒤 모델 파일을 다운로드합니다.
- 이어 Strata용 pack과 tokenizer, MTP runtime을 준비합니다. 이 과정은 아래 명령에 포함됩니다.
--no-start는 준비를 마친 뒤 서버를 자동으로 시작하지 않는 옵션입니다. 다음 절에서 접속 주소와 인증을 지정해 기동합니다.
sh setup.sh \ --setup --yes \ --family qwen --model IQ3_S \ --cuda 12 --build \ --gpu "$STRATA_GPU" \ --context 32768 --kv int8 \ --parallel 1 --vision no \ --draft-vocab cjk --low-ram off \ --experimental-speed-projection off \ --vram-reserve-mib 2048 \ --host 127.0.0.1 --port 8080 \ --no-browser --no-start \ --data-dir "$PWD/../Strata-data" -
생성된 실행 구성 확인
- 엔진:
engine-cuda12/strata - 서버 설정:
strata-iq3_s.json - 모델 ID:
qwen3.8-flash-next-iq3_s - 초기 Expert profile:
data/expert-profile.bin - 엔진 옵션: native 실행, 자동 Expert 캐시, 자동 Prefill, MTP runtime 경로가 설정 파일에 들어갑니다.
--spec 4는 현재 토큰과 최대 3개의 MTP 후보를 묶어 검증하는 설정입니다.--spec-min-p 0.5는 MTP 후보의 예측 확률을 기준으로 검증 묶음의 길이를 정하는 값입니다. 확률이 0.5보다 낮아지면 후보를 더 이어 붙이지 않고 짧은 묶음을 검증합니다.- 이 옵션들은 JSON의 엔진 인자입니다. HTTP 서버의 실행 인자와 구분합니다.
- 엔진:
이 단계가 끝나면 엔진과 모델 자료, 서버 설정이 준비됩니다.
기동에서는 준비된 설정 파일을 읽어 모델을 메모리에 올립니다.
API 서버 기동과 연결
준비된 설정으로 HTTP API 서버를 실행합니다.
서버가 Ready까지 올라오면 클라이언트에서 접근할 주소를 맞춰 연결합니다.
아래 명령은 Bash 기준이며 예시 포트는 8080입니다. 서버 실행과 클라이언트 요청에 같은 포트를 사용합니다.
-
서버 기동
- 소스를 준비한
Strata디렉터리에서 실행합니다. - 서버가 읽을 API 키는
STRATA_API_KEY환경변수로 전달합니다.
source .venv/bin/activate

read -r -s -p 'Strata API key: ' STRATA_API_KEY
echo
export STRATA_API_KEY

python serve/server.py \
  --engine strata \
  --config strata-iq3_s.json \
  --host 0.0.0.0 \
  --port 8080
모델을 읽는 동안 출력되는 초기 URL과 최종
ready:메시지는 구분해야 합니다.
최종 메시지까지 확인한 뒤 별도 터미널이나 클라이언트에서 연결합니다.
위 예시는 터미널에서 실행을 유지하는 방식입니다.Ctrl+C로 종료할 수 있습니다. - 소스를 준비한
-
접속을 받는 주소와 요청 주소 구분
- 서버의
0.0.0.0: 모든 IPv4 인터페이스에서 요청을 받는 설정입니다. - 같은 서버에서 호출:
127.0.0.1:8080으로 접속할 수 있습니다. - Docker Jupyter나 다른 장비에서 호출: 해당 환경에서 접근할 수 있는 서버의 IP 또는 호스트 이름을 사용합니다.
일반적인 Docker 네트워크에서 컨테이너의
127.0.0.1은 그 컨테이너를 가리킵니다.
GPU 서버 호스트의 localhost와는 다릅니다. Jupyter의 웹 포트와 Strata API 포트도 별개입니다. - 서버의
-
연결과 모델 준비 확인
/health는 API 키 없이 조회할 수 있습니다./v1/models에는 서버와 같은 API 키를 전달합니다. 별도 터미널에서도 같은 키를 환경변수로 설정합니다.- 아래 예시는 GPU 서버의 별도 터미널에서 실행합니다. Docker 커널에서는 요청 주소를 서버의 IP나 호스트 이름으로 바꿉니다.
curl --noproxy '*' --connect-timeout 5 --max-time 10 \
  http://127.0.0.1:8080/health

read -r -s -p 'Strata API key: ' STRATA_API_KEY
echo
export STRATA_API_KEY

curl --noproxy '*' --connect-timeout 5 --max-time 10 \
  -H "Authorization: Bearer $STRATA_API_KEY" \
  http://127.0.0.1:8080/v1/models
응답 확인할 내용 /health의service: "strata"Strata HTTP 서버에 연결됨 loaded: true모델 준비 완료 api_key: trueAPI 인증 활성화 /v1/models의 모델 ID설정한 IQ3_S 모델 확인 HTTP 401 서버에 연결됐지만 인증 정보가 맞지 않음
연결 실패와 HTTP 401은 구분해야 합니다.
연결 실패는 서버 실행 상태와 접속 주소·포트부터 확인합니다. 인증 실패는 서버와 클라이언트의 키가 같은지 확인합니다.
이 구성을 통해 Docker Jupyter에서 Strata API에 접근할 수 있었습니다.
구축 결과와 후속 확인
Strata로 IQ3_S 모델을 A100 80GB 한 장에서 구동하고 Docker Jupyter에서 API로 호출할 수 있는 구성을 만들었습니다.
기동 로그에서 전체 routed Expert 24,576개의 GPU 캐시 적재도 확인했습니다.
strata generate: expert cache auto: 73.07 GiB free, 2048 MiB reserved (+218 MiB for the draft head) -> 24576 slots
strata generate: pre-filled 24576 of 24576 slots from the profile in 2.3 s (22112 MB/s); slot 0 verified
73.07 GiB free는 캐시 크기를 계산할 때의 여유 VRAM입니다.
slot 0 verified는 첫 캐시 슬롯의 가중치를 읽어 원본과 비교한 결과입니다.
2.3 s와 22112 MB/s는 기동 중 Expert 캐시를 채운 시간과 전송률입니다.
구동 이후에 확인할 항목은 아래와 같습니다.
- 실행 중 메모리: Prefill·Decode의 RAM·VRAM 사용량과 변화
- 응답 품질: 한국어 응답, 코드 생성, 도구 호출의 결과
- 처리 성능: 입력 길이별 첫 응답 지연과 생성 속도, 여러 요청의 대기와 처리량
- 운영 조건: 장시간 실행과 재시작, 오류 후 복구
이 항목들은 같은 시작 설정을 기준으로 후속 테스트에서 확인해보겠습니다.