AWS 데이터 & 분석
Amazon Athena
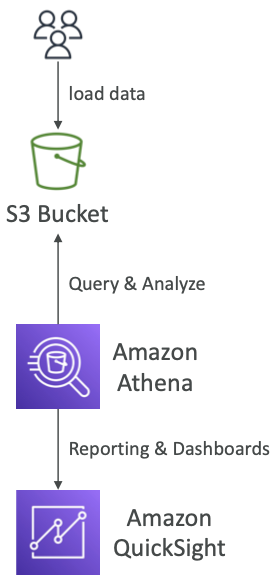
- S3 버킷에 저장된 데이터 분석에 사용하는 서버리스 쿼리 서비스
- 표준 SQL언어로 파일을 쿼리해야함
- SQL 언어를 사용하는 Presto 엔진에 빌드된다
- 버킷의 데이터를 바로 분석
- CSV, JSON, ORC, Avro, Parquet을 지원
- 가격 책정은 간단하며 스캔된 데이터의 TB당 고정 가격을 지불하기 때문에 프로비저닝이 필요 없다
- QuickSight라는 도구와 함께 사용보고서와 대시보드를 생성
- 임시 쿼리 수행이나 BI / 분석/ 보고 & AWS 서비스에서 발생하는 모든 로그를 쿼리하고 분석
- VPC 흐름 로그, 로드 밸런서 로그, CloudTrail 추적 등
서버리스 SQL 엔진을 사용한 아마존 S3 데이터 분석 → Athena
Performance Improvement
성능향상이 가능하며 시험에서 이를 물어볼 수 있다
- 데이터를 적게 스캔할 수 있는 columnar(컬럼 - 열) 유형의 데이터를 사용
- Apache Parquet과 ORC을 사용하면 성능이 크게 향상된다
- Glue등으로 CSV와 Parquet간의 데이터 전환이 가능
- 데이터를 압축하여 더 적게 검색해야 한다
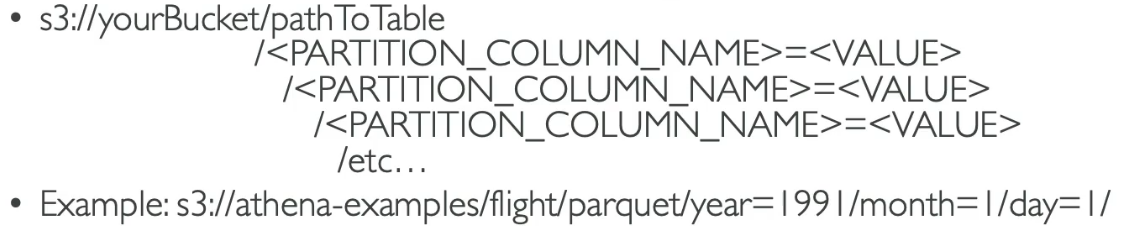
- 데이터셋 분할 → S3 버킷에 있는 전체 경로를 슬래시로 분할
- 각 슬래시에 다른 열 이름을 붙여 열별로 특정 값을 저장
- 특정 열별로 데이터를 필터할 수 있다
- 큰 파일을 사용해 오버헤드 최소화
- 작은 파일이 많으면 성능이 떨어진다 파일이 클수록 검색이 쉬움
Federated Query
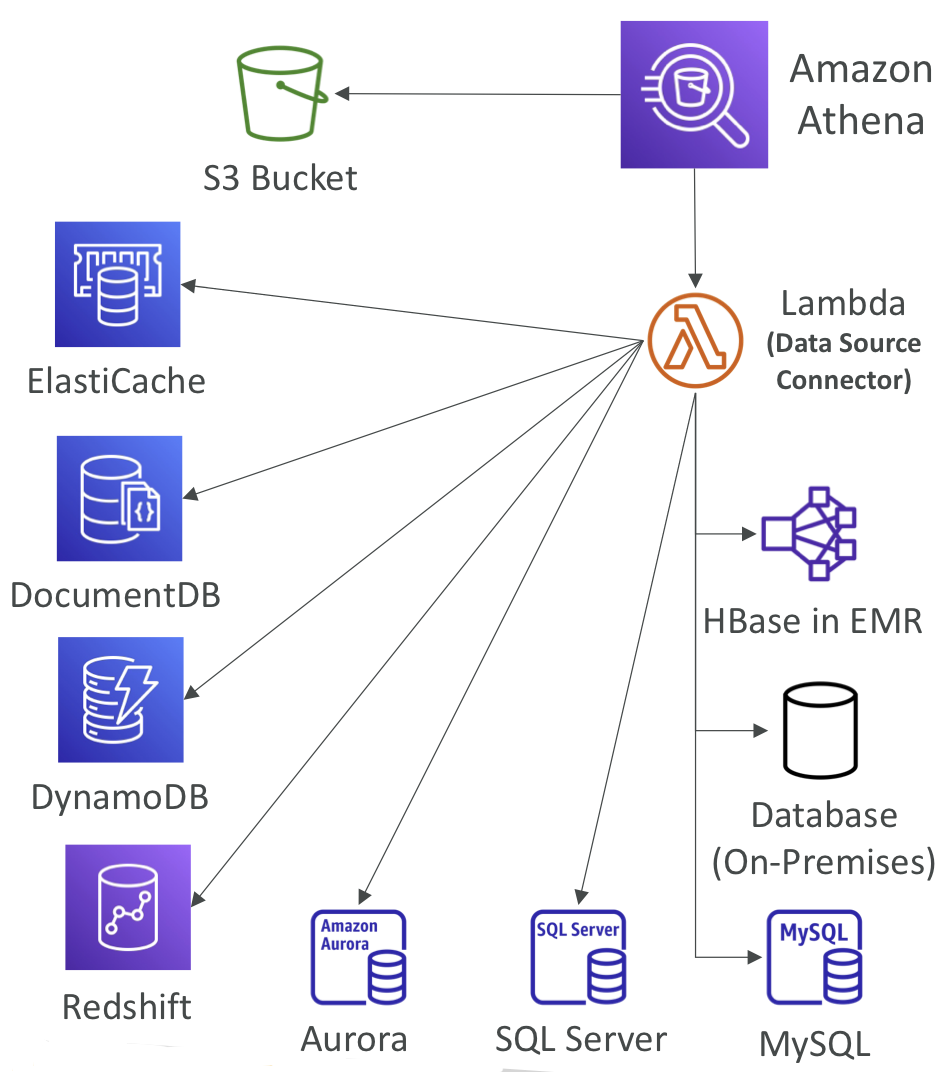
- S3 뿐만 아니라 어떤 곳의 데이터도 쿼리할 수 있다
- 관계/비관계형 데이터베이스, 객체, 사용자 지정 데이터 원본 등을 쿼리할 수 있다
- 데이터 원본 커넥터(람다 함수)를 사용한다
실습
서버 설정과 데이터 변환 없이도 적절한 데이터 포맷을 설정함으로써 복잡한 쿼리를 직접 실행해 원하는 결과를 얻을 수 있다
Redshift
- PostgreSQL 기반 데이터베이스이자 분석 엔진 → OLTP에 사용되지 않는다
- OLAP (Online Analytical Processing(분석과 데이터 웨어하우징)에 사용
- 데이터 규모가 PB 단위의 데이터까지 확장 가능
- 모든 데이터를 Redshift에 로드하면 Redshift에서 빠르게 분석 가능
- Columnar 기반 스토리지를 사용하기 때문에 병렬 쿼리 엔진이 있고 성능 향상이 가능
- 프로비저닝한 인스턴스에 대한 비용만 지불
- 쿼리수행시 SQL 가능
- Quicksight, Tableau같은 도구도 Redshift와 통합 가능
- vs Athena
- 모든 데이터를 Redshift로 로드해야함
- 일단 로드하고나면 쿼리가 더 빠르고 조인과 통합을 빠르게 할 수 있음
- 인덱스를 빌드하기 때문
- 쿼리가 많고 복잡, 집중적인 데이터 웨어하우스라면 Redshift
Redshift Cluster
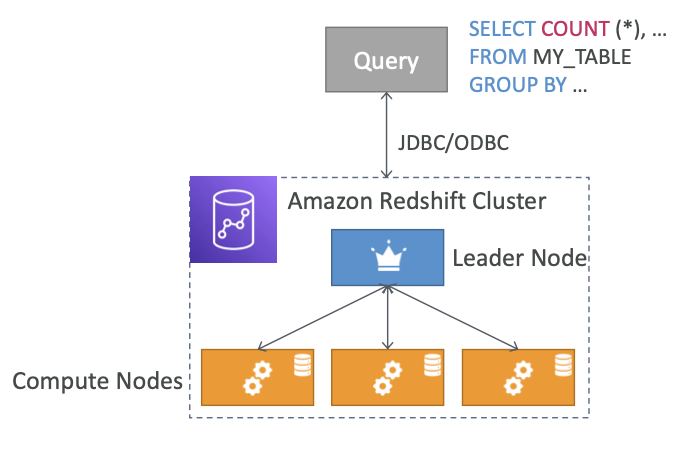
- Leader node: 쿼리를 계획하고 결과를 집계
- Compute node: 쿼리를 실행하고 결과를 리도로 보냄
- 노드 크기를 미리 프로비저닝 해야하고 비용을 절감하려면 예약 인스턴스를 사용하면 된다
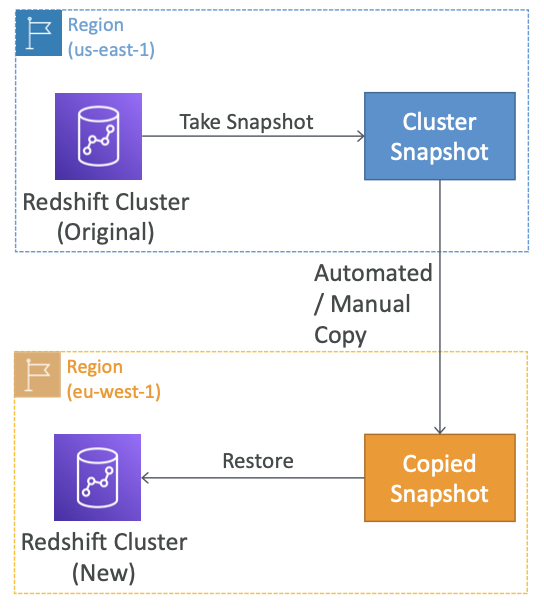
Redshift - Snapshots & DR(스냅샷과 재해복구)
- 다중 AZ모드가 없고 한개의 가용영역에 존재
- 따라서 재해복구전략을 적용하려면 스냅샷을 사용해야 한다
- 스냅샷은 클러스터 지정 시간 백업
- S3 내부에 저장되며 증분한다
- 변경된 사항만 저장되므로 저장공간 절약 가능
- 새로운 클러스터에 복구 가능
- 스냅샷은 수동 사용 or 자동화를 통해 만들 수 있다
- 수동으로 만들경우 삭제 전까지 유지됨
- 자동이든 수동이든 클러스터의 스냅샷을 다른 AWS 리전에 자동으로 복사해서 재해복구전략을 사용한다
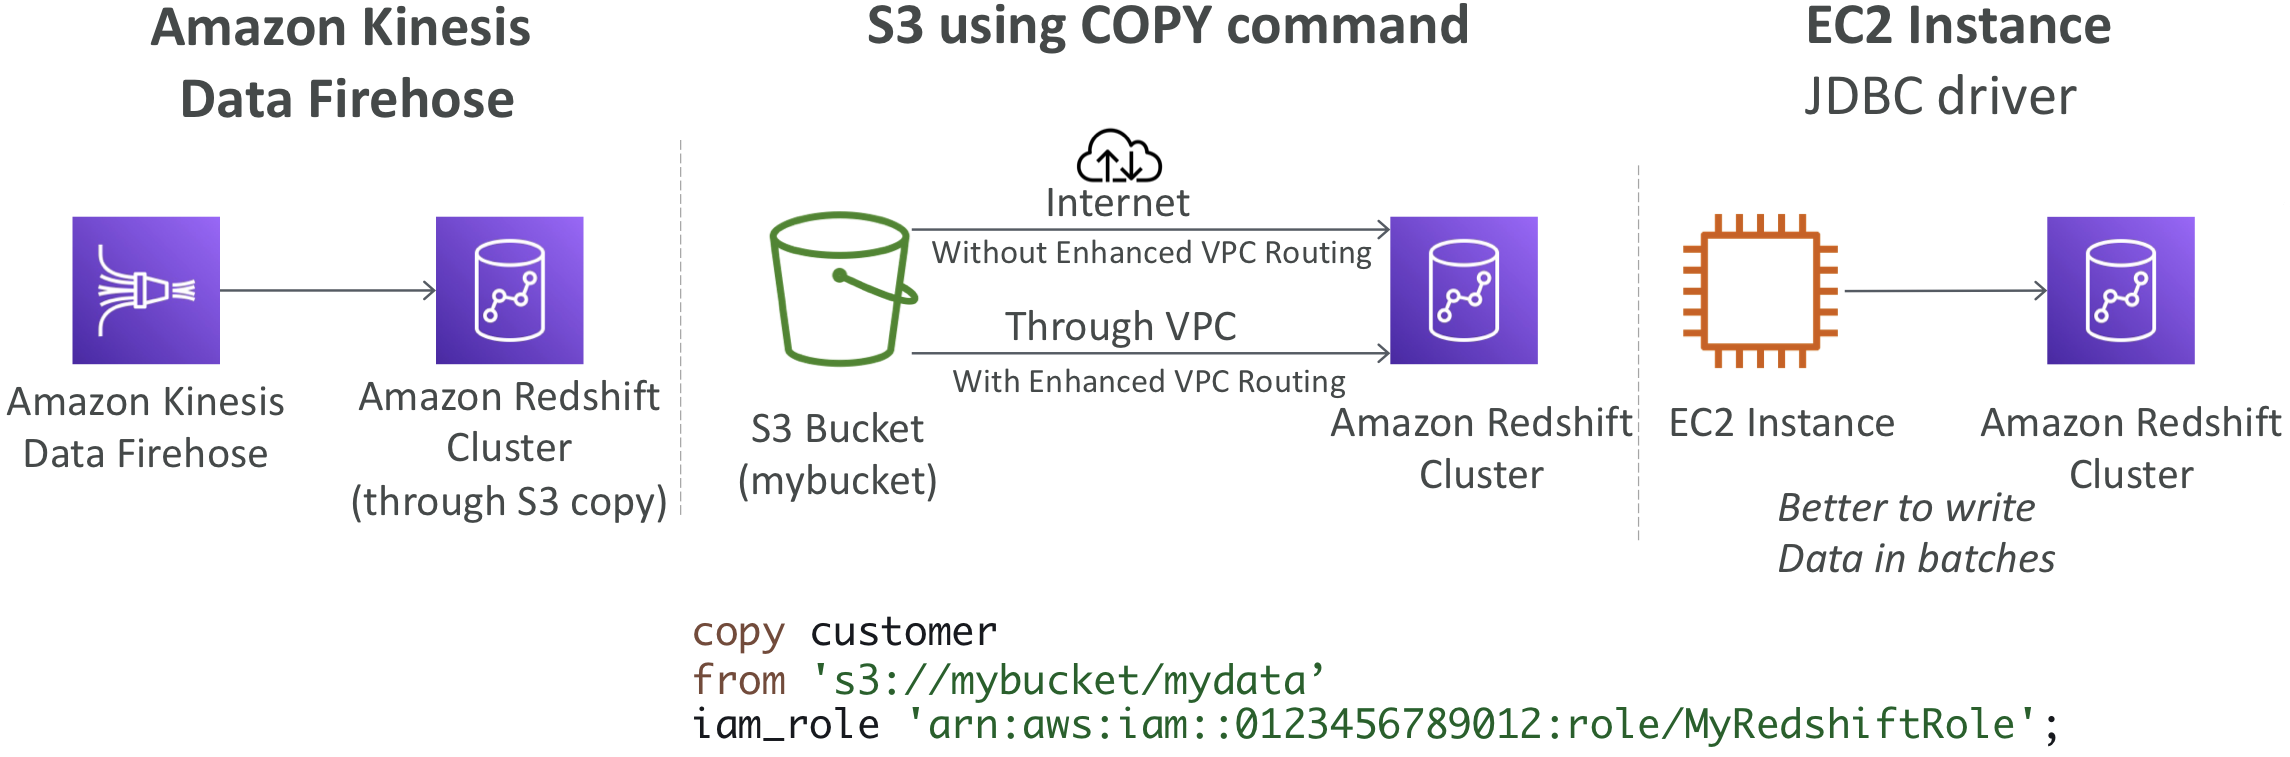
Redshift에 데이터 주입 방법
- Kinesis firehose(s3버킷에 데이터를 넣으면 kinesis가 복사)
- s3 버킷
- JDBC(배치로 데이터를 쓰는게 좋다 → 하나씩 하는건 비효율적)
Redshift Spectrum
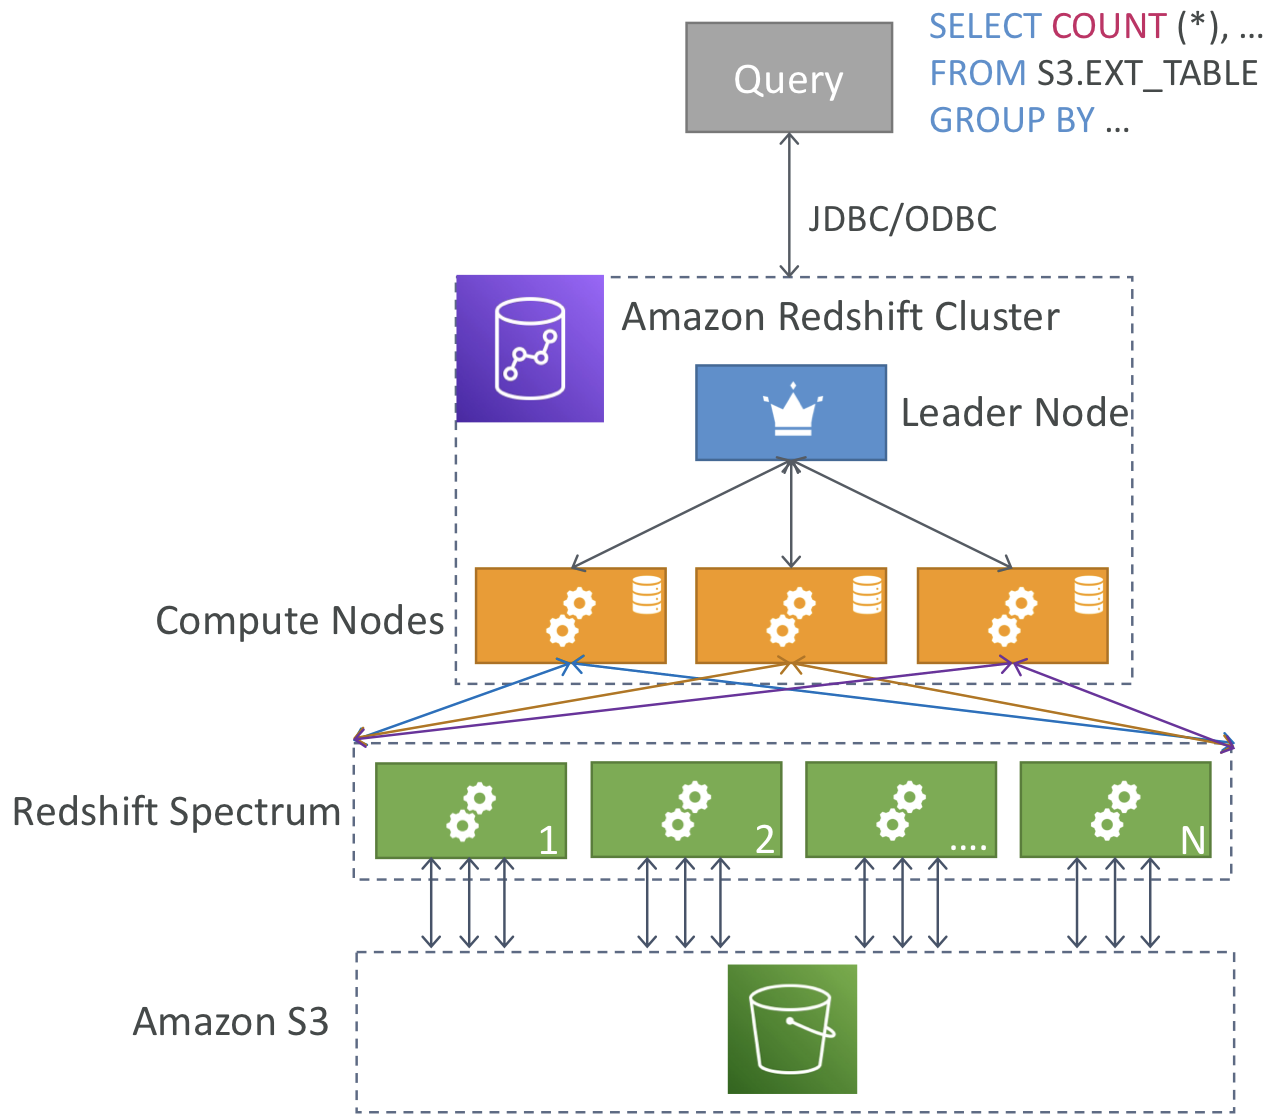
- S3에 있는 데이터를 Redshift를 사용해 분석하지만 Redshift로 로드는 하지 않는다
- 더 많은 처리능력을 사용하기 위함
- 쿼리를 시작할 수 있는 Redshift 클러스터가 있어야한다
- 쿼리는 S3에서 데이터를 읽고 집계하는 수천 개의 스펙트럼 노드에 제출된다
Amazon OpenSearch
- ElasticSearch의 후속 서비스 → 라이선스 문제로 이름 변경
- 모든 필드를 검색할 수있다
- 애플리케이션에서 검색 기능을 제공하거나 다른 데이터베이스를 보완하기 위해 사용
- 검색이나 쿼리 분석할 때 사용
- 인스턴스의 클러스터를 생성해야한다(Not serverless)
- SQL을 지원하지않고 자체적인 쿼리언어를 가진다
- Kinesis Data Firehose, AWS IoT, CloudWatch Logs 사용자 지정 애플리케이션으로 데이터 주입 가능
- Cognito & IAM, KMS, TLS를 통한 보안
- OpenSearch Dashboard를 통한 데이터 시각화가 가능
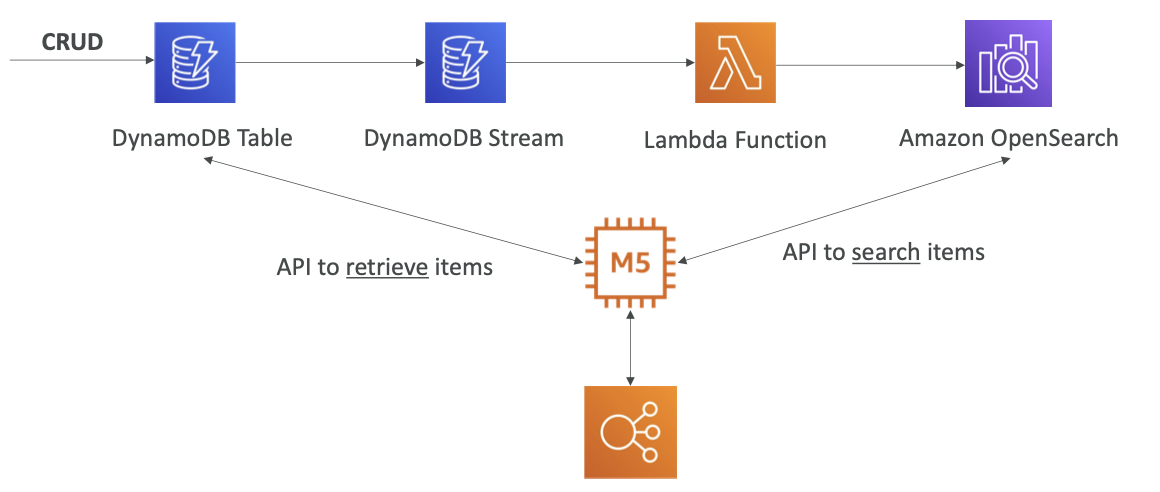
OpenSearch Patterns
DynamoDB
- 먼저 OpenSearch를 찾아서 ID를 가져온 뒤 DynamoDB 테이블과 연결한다
CloudWatch Logs
- 람다를 통한 실시간 데이터 주입
- Kinesis Data Firehose를 통한 근실시간 데이터 주입
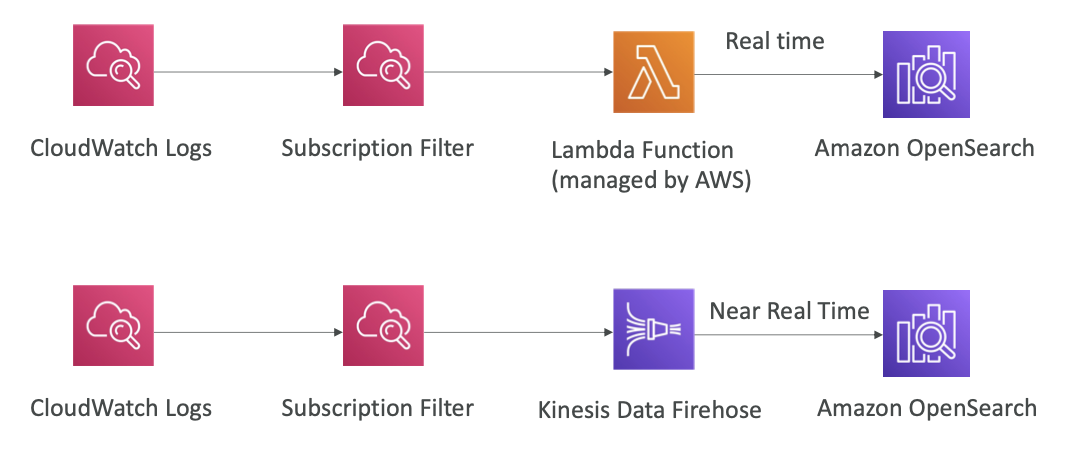
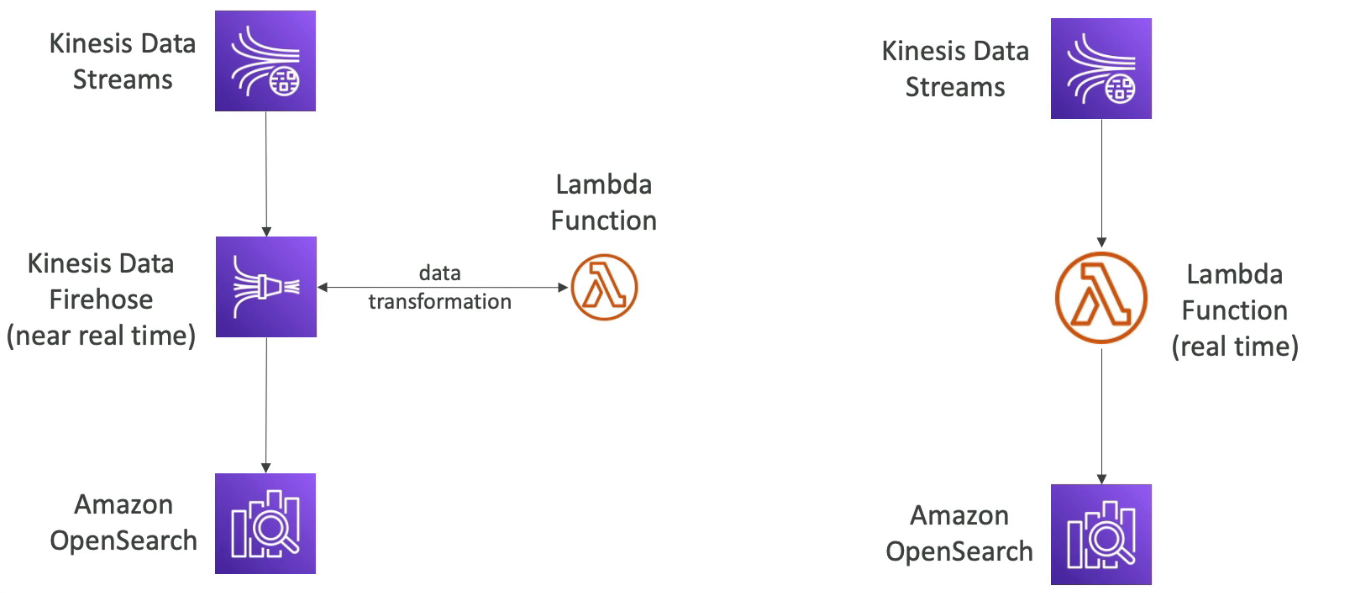
Amazon EMR(Elastic MapReduce)
- 빅데이터 작업을 위한 하둡 클러스터를 생성하는데 사용
- 데이터 분석 처리 / 하둡 클러스터 → Amazon EMR
- 프로비저닝해야하며 수백 개의 EC2 인스턴스로 구성될 수 있다
- 빅데이터 전문가가 사용하는 여러 도구와 함께 제공된다
- Apache Spark ,HBase, Presto, Flink
- 전체 클러스터를 자동 확장해주고 스팟 인스턴스와 통합된다
데이터 처리, 머신러닝, 웹 인덱싱, 빅데이터 작업
EMR - Node types & purchasing
- 마스터 노드 → 클러스터를 관리하며 다른 모든 노드의 상태를 조정하며 장기 실행해야함
- 코어 노드 → 태스크 실행, 데이터 저장 → 장기 실행
- 태스크 노드 → 태스크만 실행, 대게 스팟 인스턴스를 사용 / 태스크노드 사용은 선택사항임
- 온디맨드 EC2 유형 → 신뢰성, 예측 가능한 유형의 워크로드 / 종료되지 않는다
- 예약 인스턴스 → 비용 절약, EMR이 자동으로 인스턴스를 에약
- 주로 마스터노드와 코어노드에 적합
- 스팟 인스턴스 → 종료될 수 있지만 싸다 / 태스크노드에 적합
장기 실행 클러스터에서 예약 인스턴스 사용 혹은 임시 클러스터를 사용해 특정 작업을 수행하고 분석 완료 후 삭제하는 방식이다
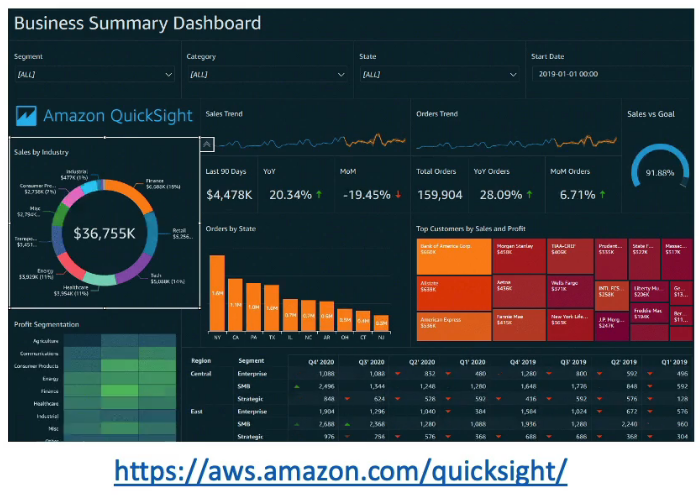
Amazon QuickSight
- 서버리스 머신 러닝 기반 BI 서비스 → 대화형 대시보드
- 빠르고 자동화, 오토스케일링, 임베디드가 가능하며 세션당 비용을 지불
- 비즈니스 분석, 시각화된 정보를 통한 임시 분석 수행, 비즈니스 인사이트
- 다양한 데이터 소스에 연결 가능
- SPICE 엔진을 통해 데이터를 직접 가져올 때 인메모리 계산이 가능
- 사용자 수준의 기능을 제공(CLS - Column-Level security) 보안을 제공
QuickSight 통합
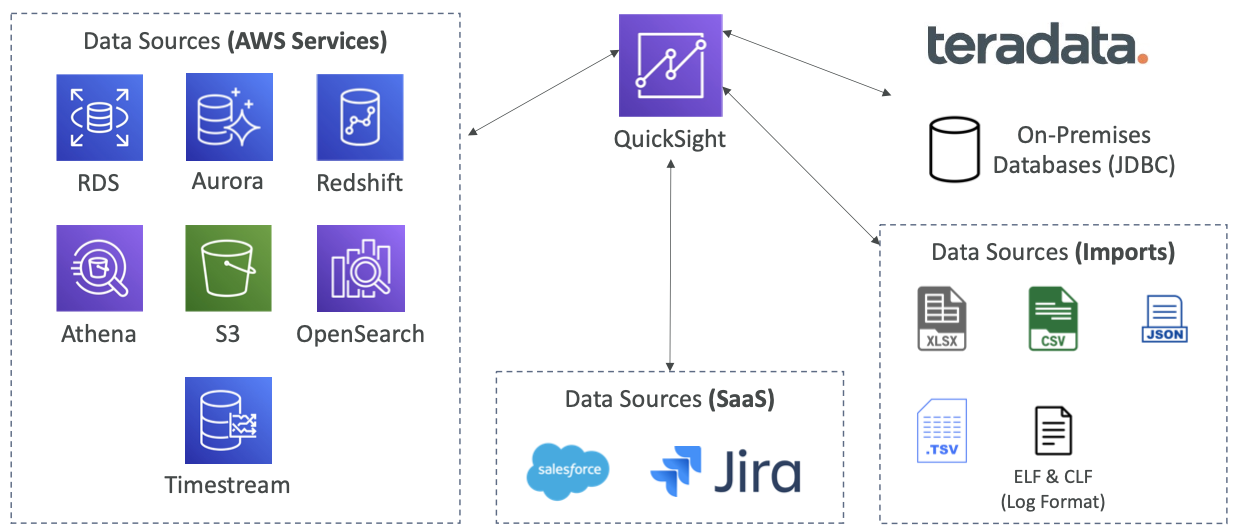
시험에서는 QuickSight를 Athena or Redshift와 함께 사용하는 문제가 나온다 다른 통합도 가능
Dashboard & Analysis
- 스탠다드 버전 → 사용자 정의 / 엔터프라이즈 버전 → 그룹 정의 가능
- 이때 사용자와 그룹은 IAM과 다른 QuickSight 전용 Role임
- 대시보드는 읽기 전용 스냅샷으로 읽기 결과 공유 가능
- 분석을 위해 설정한 옵션 값등이 저장되어 대시보드에 표시
- 분석이 더 충실하며 특정 사용자 혹은 그룹과 공유 가능
- 엑세스 권한이 있으면 볼 수 있고 게시하면 공유 가능
AWS Glue
- 추출과 변환, 적재하는 ETL 서비스(Extract, Transform, Load)
- 분석을 위해 데이터 준비 변환에 매우 유용
- 서버리스 서비스로 모든 작업을 수행
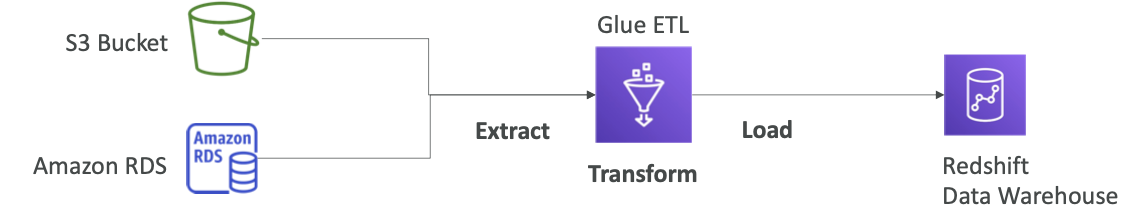
데이터를 Parquet format하는 예시
- Parquet은 Columnar기반의 데이터 형식
- Athena와 같이 사용하면 효과적
- S3 버킷에 파일이 삽입될 때마다 람다함수 or EventBridge로 Glue ETL을 트리거하여 자동화 가능
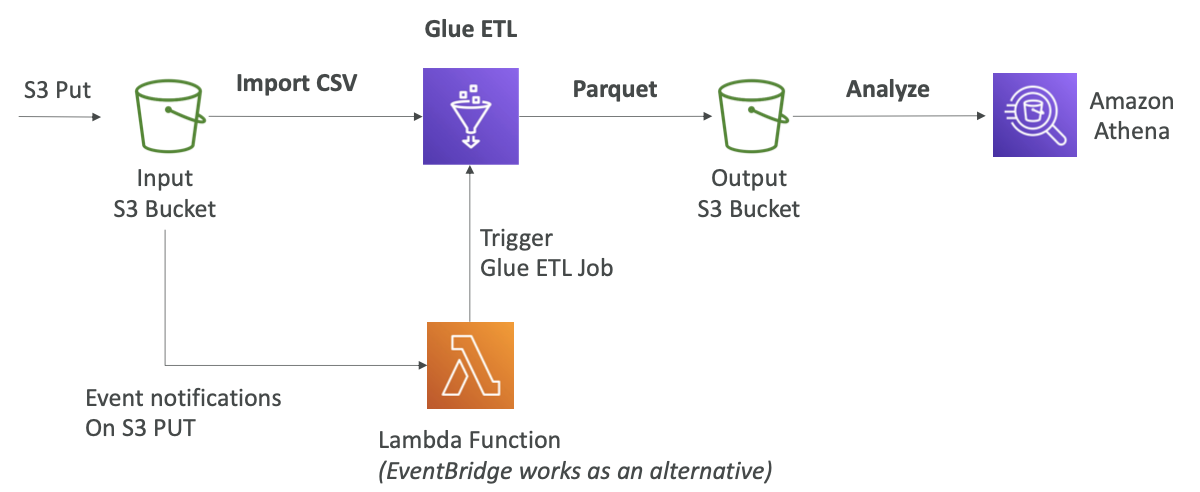
Glue Data Catalo
리소스에서 데이터를 가져와 ETL작업을 거쳐 다른 데이터 분석 서비스로 전달이 가능하다
더 알아야 하는 부분
- Glue 작업 북마크 → 새 ETL 작업을 실행할 떄 이전 데이터의 재처리를 방지
- Glue Elastic Views
- SQL문을 사용해 여러 데이터 스토어의 데이터를 결합하고 복제한다
- RDS, S3, Aurora에 걸친 뷰를 만들 수 있다
- 커스텀 코드를 지원하지 않고 원본 데이터의 변경사항을 모니터
- 가상 테이블을 생성가능
- Glue DataBrew → 사전 빌드된 변환을 사용해 데이터를 정리하고 정규화
- Glue Studio → ETL 작업을 생성, 실행 및 모니터링하는 GUI
- Clue Streaming ETL → Apache Spark Structured Streaming위에 빌드되며 배치작업이 아니라 스트리밍 작업으로 실행 가능하며 AWS의 관리형 Kafka인 MSK에서 Streaming ETL을 사용해 데이터를 읽을 수 있다
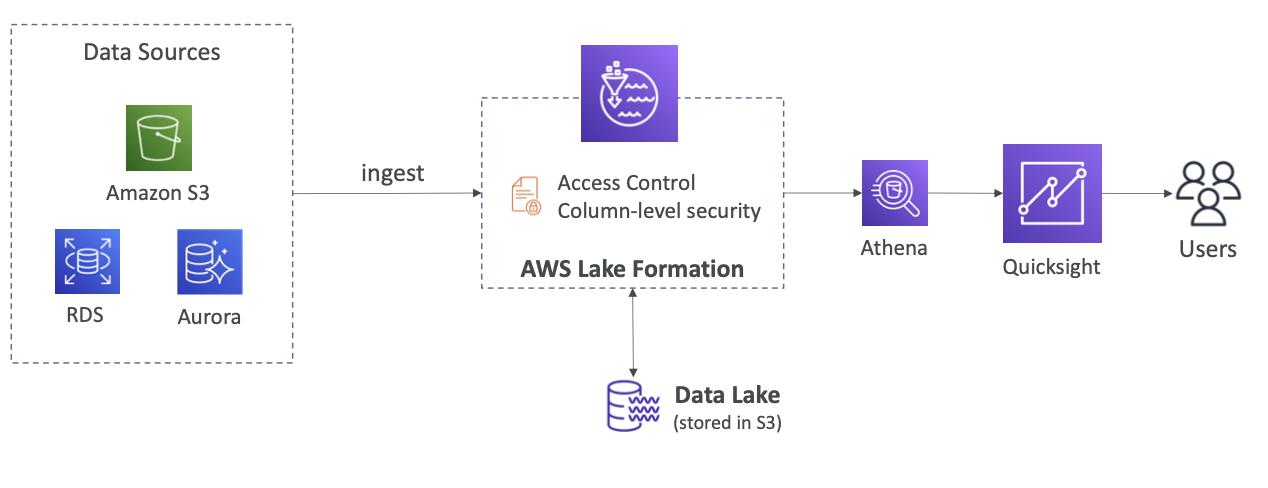
AWS Lake Formation
-
데이터 레이크 생성을 돕는데 데이터 레이크란 데이터 분석을 위해 모든 데이터를 한곳으로 모아주는 중앙 집중식 저장소
-
데이터 레이크 생성을 수월하게 해주는 완전 관리형 서비스
-
데이터 검색, 정제, 변환 주입을 돕는다
-
복잡한 수작업을 자동화하고 기계학습 변환 기능으로 중복제거를 수행
-
정형 데이터와 비졍형 데이터 소스를 결합가능하며 블루 프린트를 제공한다
- 내장된 블루 프린트는 데이터를 데이터 레이크로 이전(마이그레이션)하는 것을 도와준다
-
S3, RDS, NoSQL DB등을 지원
-
데이터를 한 곳에서 처리하는 것 외에도 행,열수준의 세분화된 엑세스 제어를 할 수 있다
-
Glue위에서 작동하지만 직접 상호작용하지는 않는다
-
블루프린트를 통한 데이터 주입(Ingest)
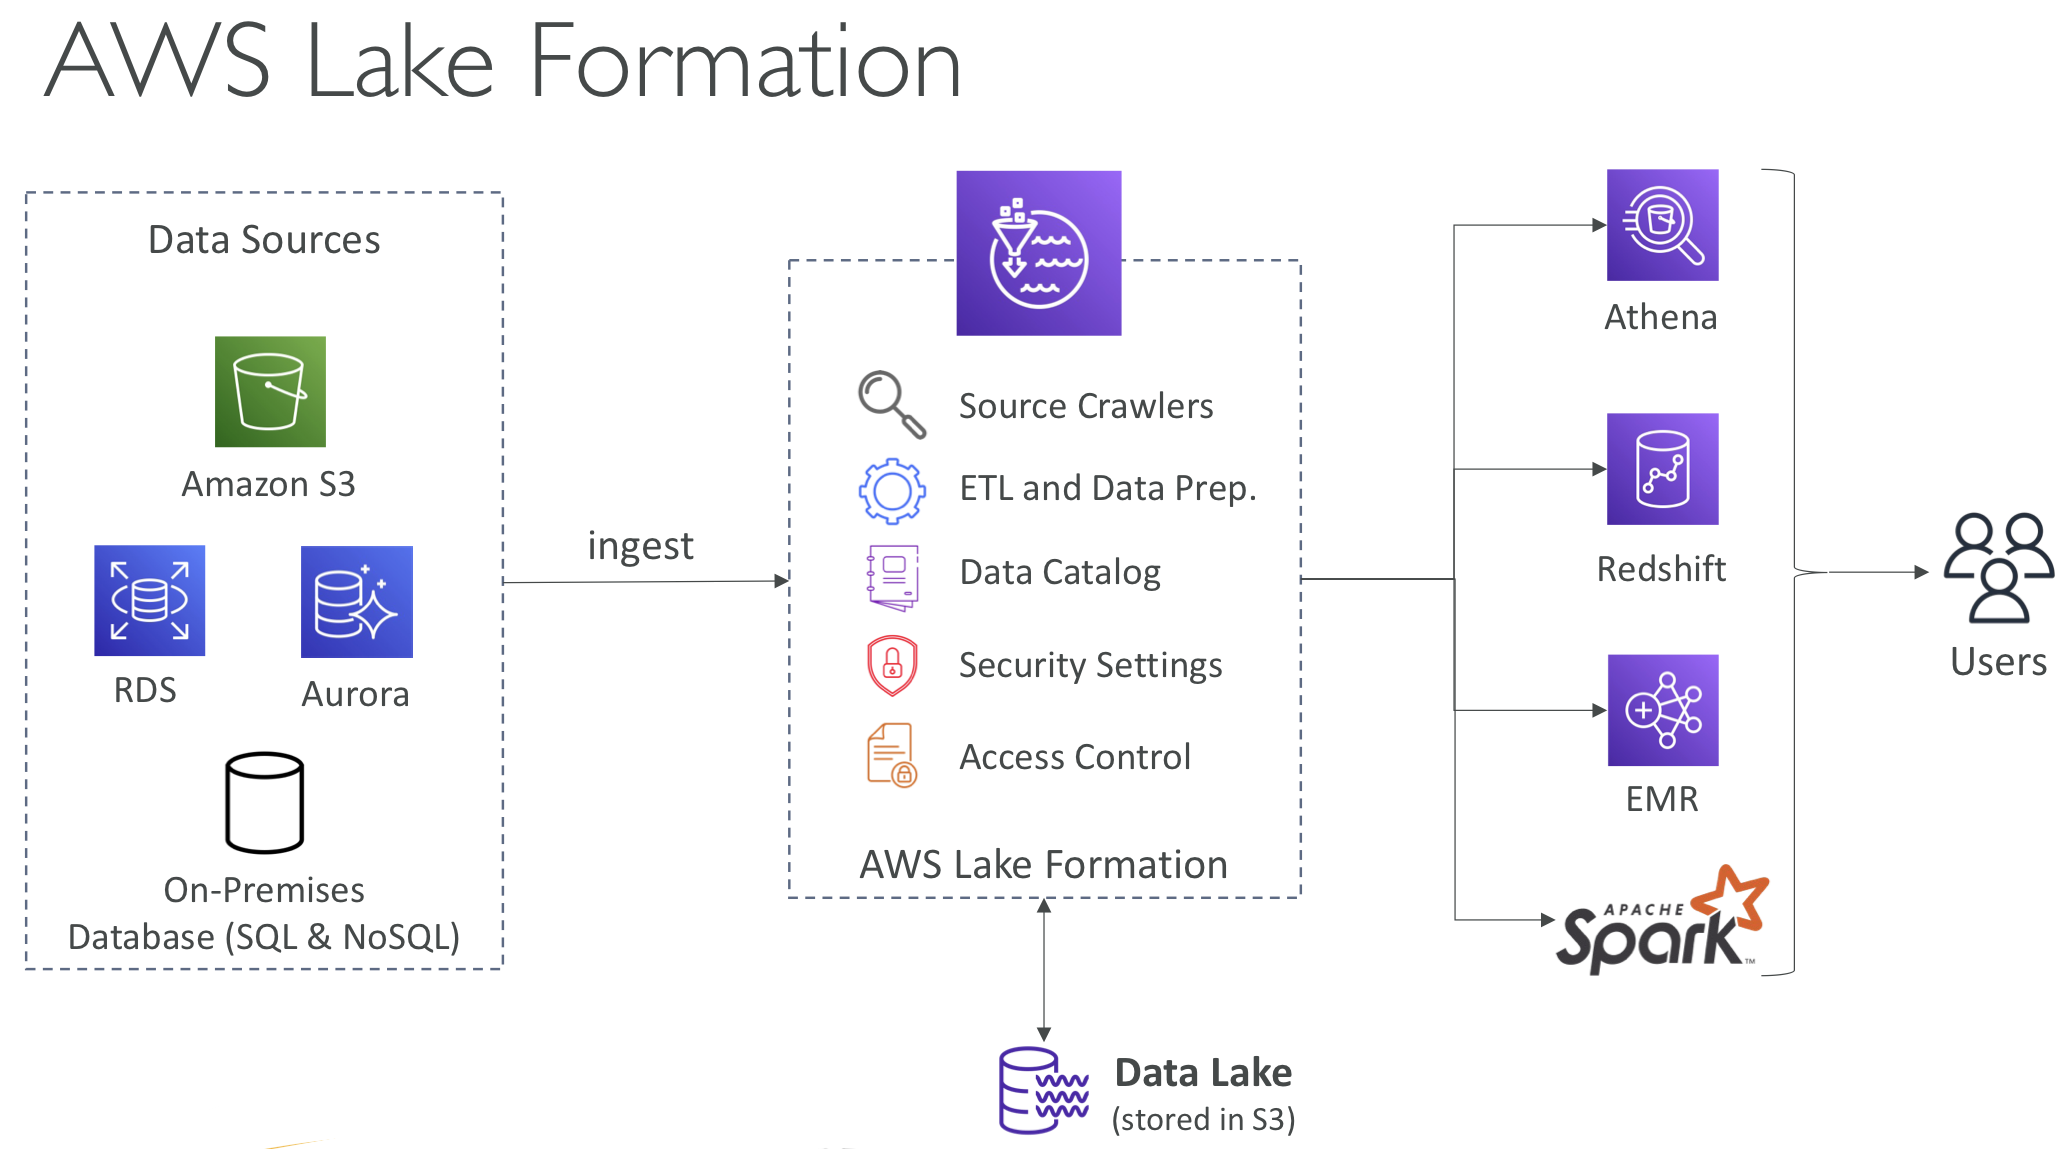
Lake Formation이 사용되는 가장 핵심적인 이유
중앙화된 권한 → 사용자가 볼 수 있는 데이터를 제어할 수 있다
- 보안 정책을 한 곳에서 설정할 수 있다는게 큰 이유
- 그게 아니라면 각 서비스마다 설정이필요함
- 주입된 데이터는 모두 중앙 S3 버킷에 저장되지만 행렬 수준 보안과 엑세스 제어는 Lake Formation에서 수행됨
- Lake Formation에 연결하는 서비스는 읽기 권한이 있는 데이터만 볼 수 있다
Kinesis Data Analytics
- SQL 애플리케이션 용 Apache Flick용으로 나뉜다
SQL 애플리케이션용 Kinesis Data Analytics
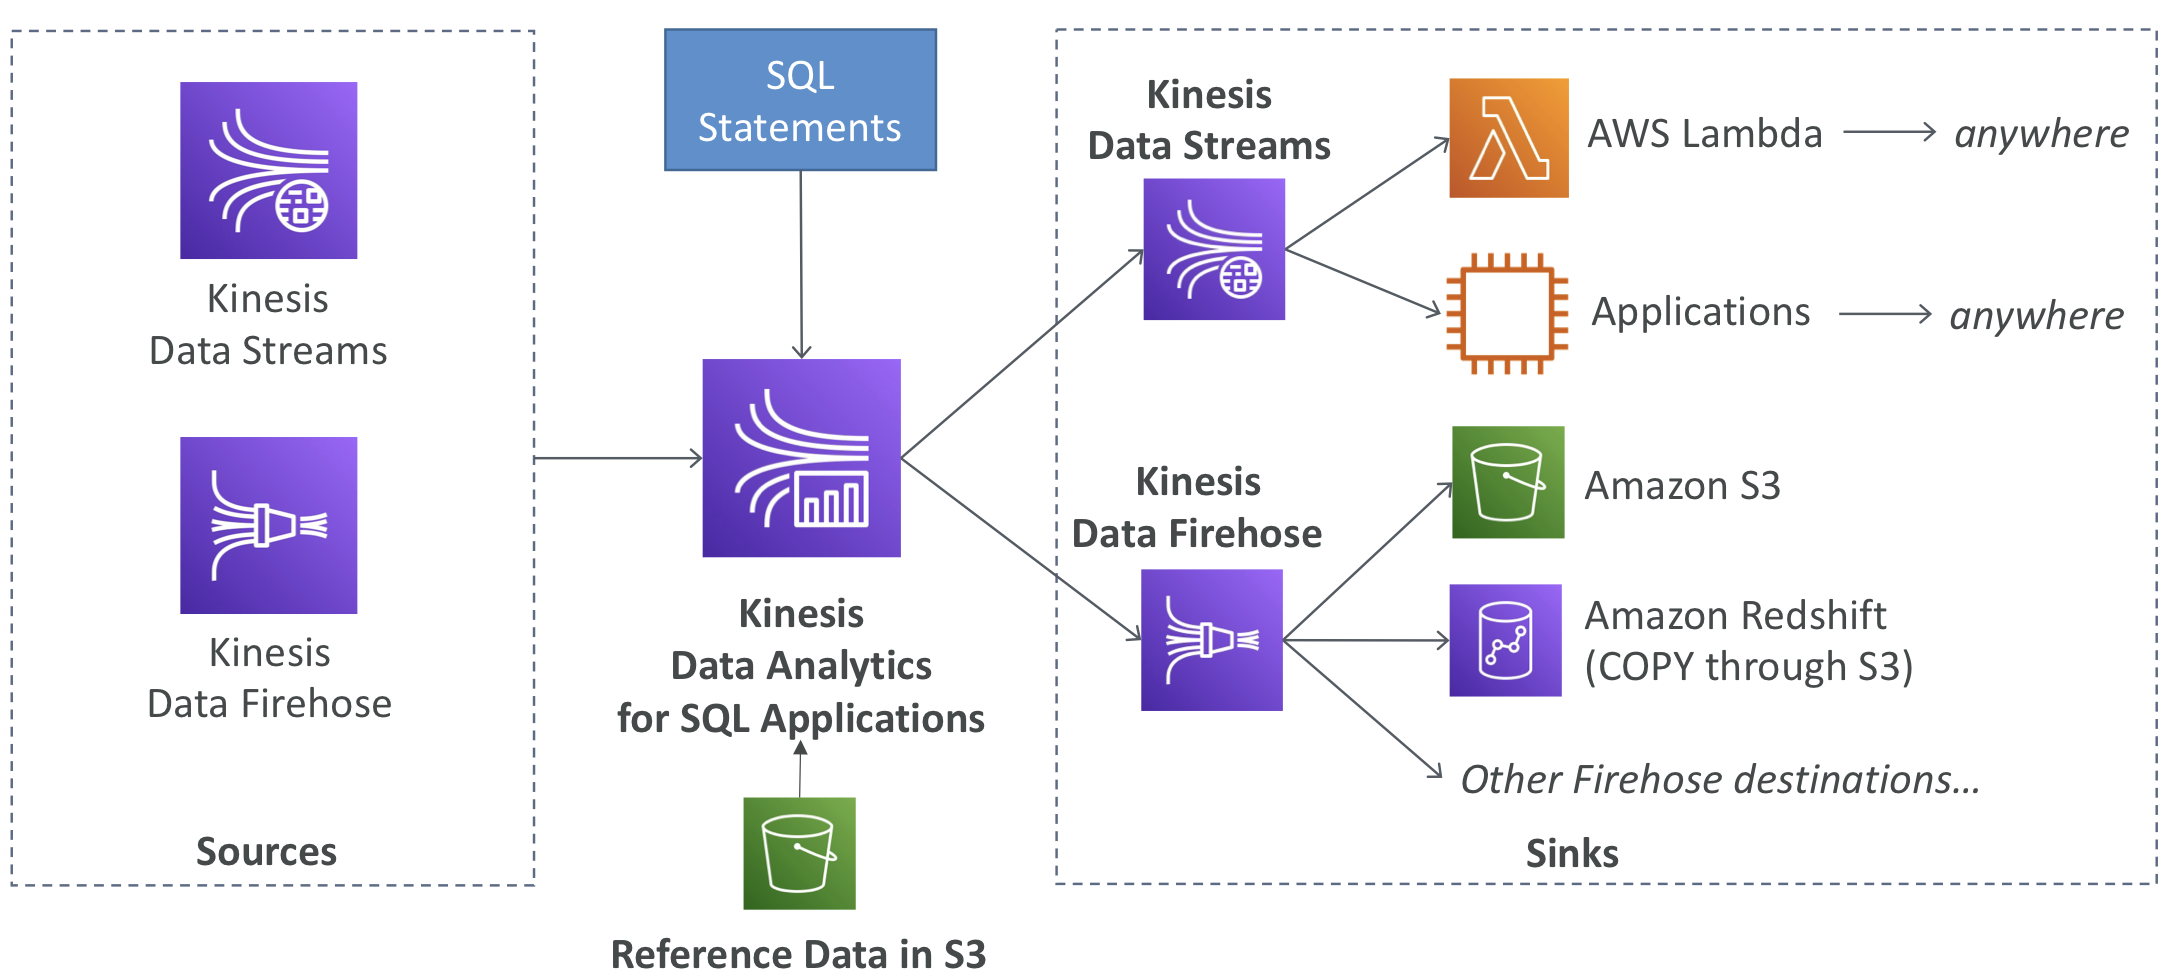
- 데이터 소스로는 Kinesis Data stream & firehose가 있다
- S3로 참조 데이터를 추가하여 데이터 보강이 가능
- 완전 관리형 서비스로 프로비저닝이 필요없다
- 오토 스케일링, 전송된 데이터만큼 비용을 지불
- 결과
- Kinesis Data Streams: 실시간 분석 쿼리에서 스트림을 생성해서 전송
- Kinesis Data Firehose: 분석 쿼리 결과를 대상으로 전송
- 시계열 분석, 실시간 대쉬보드, 실시간 지표 등에 사용됨
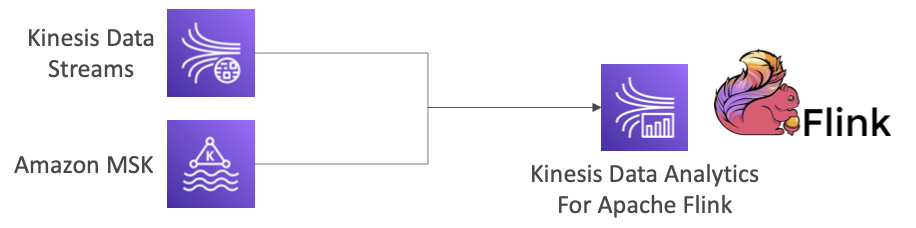
Apache Flink용 Kinesis Data Analytics
- Java, Scala or SQL로 애플리케이션을 작성하고 스트리밍 데이터를 처리, 분석할 수 있다
- Flink는 코드로 작성해야하는 특별한 애플리케이션(이후 Flink 전용 컬러스터에서 Kinesis Data Analytics를 실행 가능)
- Data Streams와 MSK 데이터 소스에서 데이터를 가져올 수 있다
- AWS 관리형 클러스터에서 Apache Flink 애플리케이션 실행 가능
- Flink는 표준 SQL보다 뛰어나기 때문에 고급 쿼리 능력이 필요하거나 Data Streams나 Kafka인 MSK같은 서비스로부터 스트리밍 데이터를 읽는 능력이 필요할 때 사용
- 자동으로 프로비저닝되며 병렬연산과 오토스케일링 가능
- 체크포인트와 스냅샷을 통한 백업
- Apache Flink 프로그래밍 기능을 사용 가능
- 주의할점은 Firehose 데이터는 읽지 못한다
- Firehose에서 데이터를 읽고 실시간 분석하려면 SQL 애플리케이션용 Kinesis Data Analytics사용해야한다
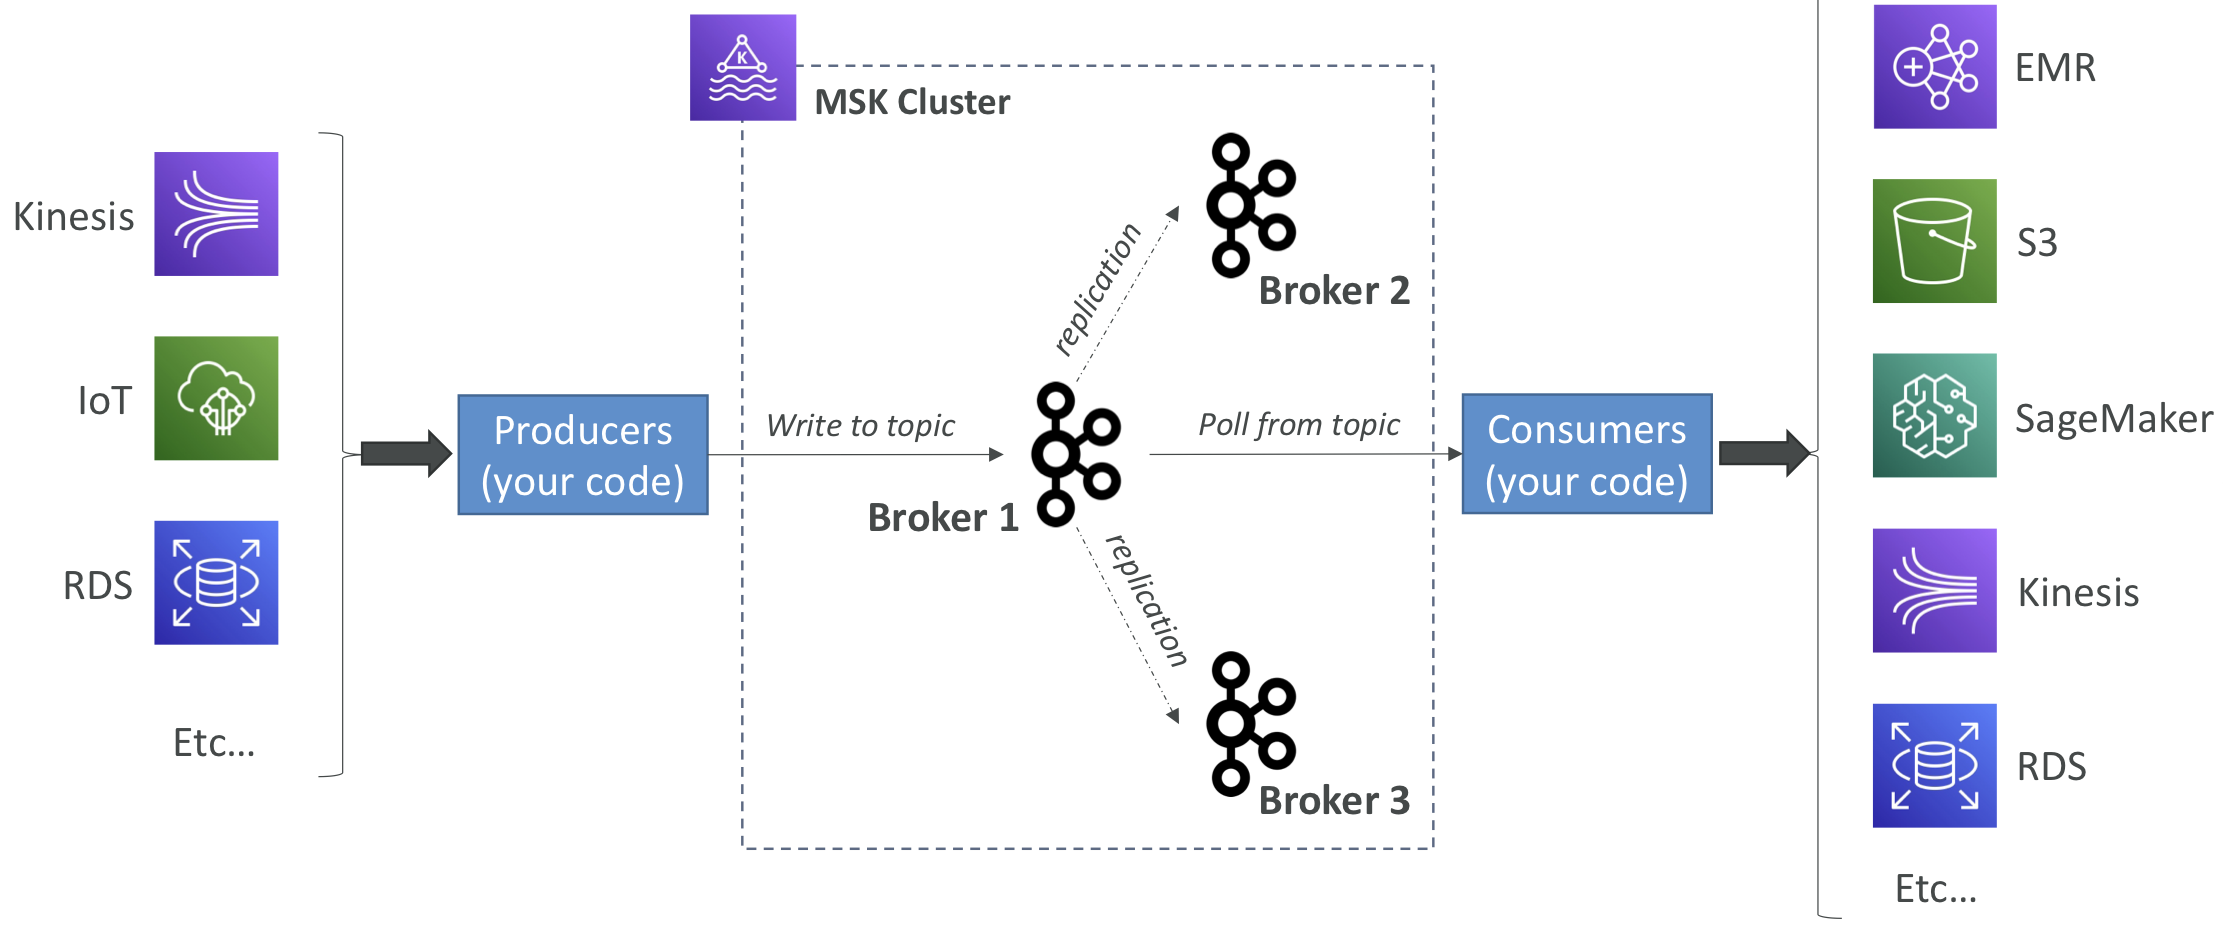
Amazon Managed Streaming for Apache Kafka (Amazon MSK)
- Kafka는 Kinesis의 대용
- 완전 관리형 Kafka 클러스터 서비스
- 그때그때 클러스터를 생성, 업데이트, 삭제한다
- 클러스터 내 브로커 노드와 Zookeeper 브로커 노드를 생성 및 관리
- 고가용성을 위해 VPC의 클러스터를 최대 세 개의 다중 AZ에 전역 배포
- 장애 자동 복구
- EBS 볼륨에 데이터 저장 가능
MSK Serverless
- Kafka를 실행하지만 용량 관리 없이 사용 가능
- MSK가 자동으로 리소스를 프로비저닝하고 컴퓨팅 및 스토리지를 확장
Apache Kafka - 더 알아야하는 부분
Apache Kafka는 데이터를 스트리밍하는 방식
KinesisData streams vs Amazon MSK
KinesisData streams
- 1MB의 메시지 크기 제한
- 샤드로 데이터를 스트리밍
- 샤드 분할 & 축소
- 전송 중 TLS암호화
Amazon MSK
- 1MB가 기본 10MB까지 확장
- 파티션을 이용한 Kafka 토픽을 사용
- 파티션 추가로 토픽 확장만 가능(제거 불가능)
- 평문과 TLS 전송 중 암호화
- 원한다면 1년 이상 데이터를 보관 가능 → EBS 스토리지 비용 지불시
두가지 다 저장 데이터 암호화가 가능
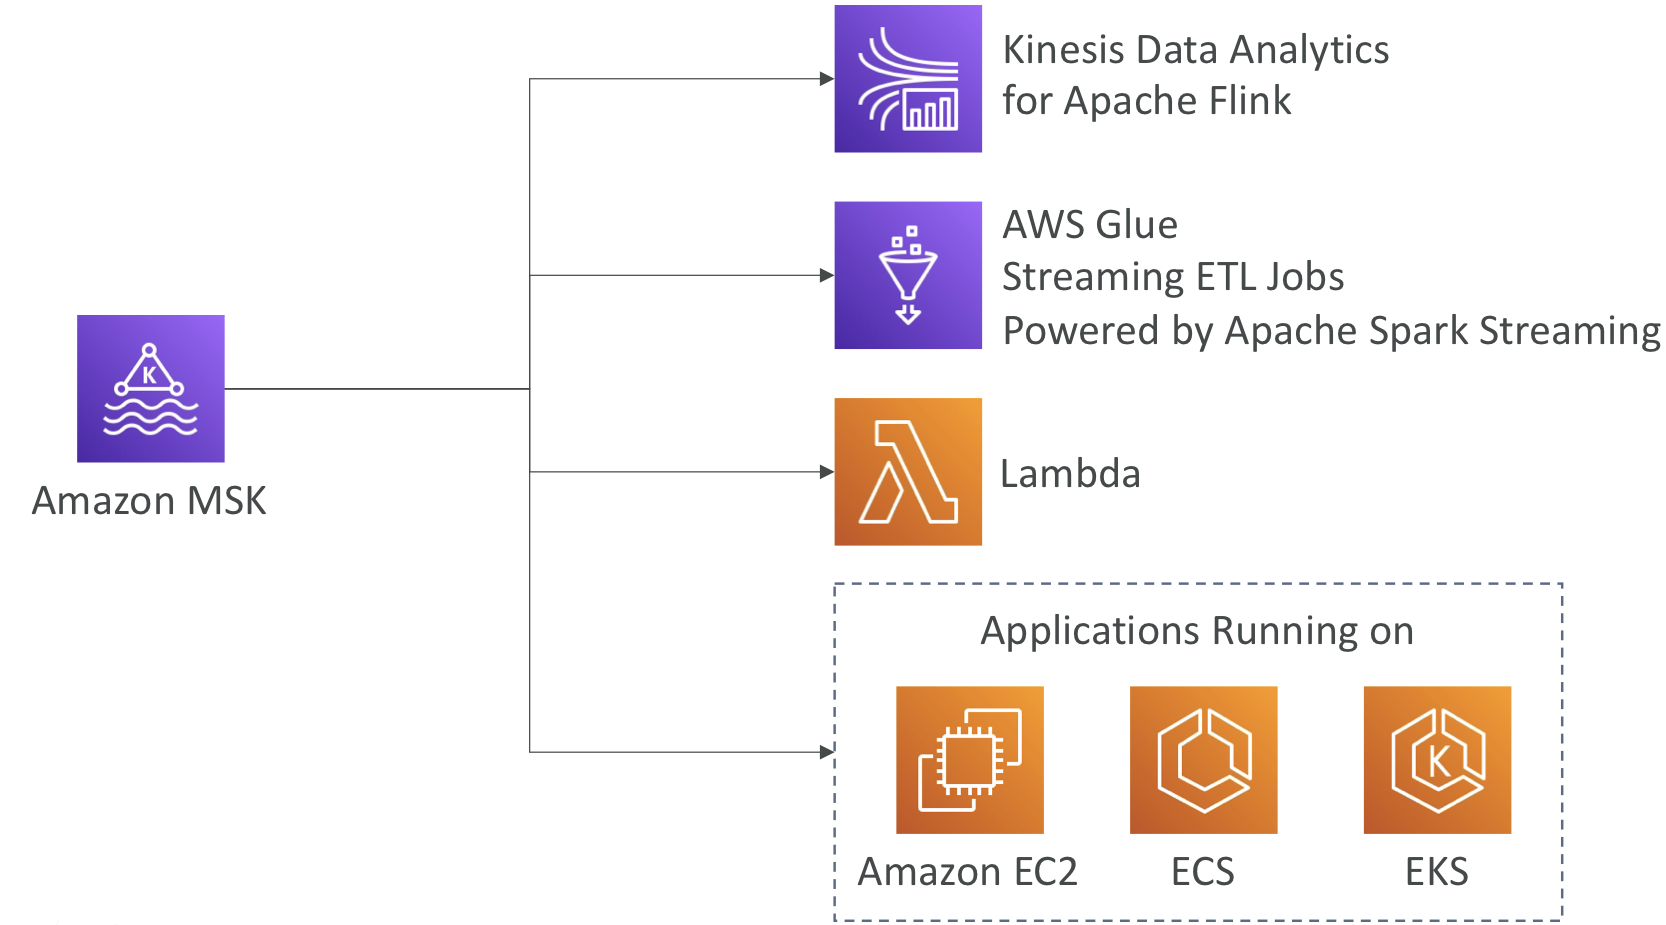
MSK의 데이터 소비자 및 소비하는 방법
- Flink앱을 실행해서 읽어오기
- ETL 작업을 스트리밍 구성 가능(Apache Spark Streaming으로 구동)
- 자체 소비자 또한 구성 가능
Big Data Ingestion Pipeline
- 실시간 데이터 수집, 데이터 변형, 변형된 데이터를 SQL을 통해 요청
- 쿼리를 사용해 생성한 보고서가 S3 에 저장
- 데이터를 데이터 웨어하우스에 넣어 대쉬보드로 생성
IoT Core는 IoT 장치 관리를 돕는다
IoT Core에서 실시간으로 Kinesis로 보낸다
Firehose를 거쳐 1분마다 데이터를 S3 버킷에 입력하고 오프로드한다
→ 여러 장치에서 많은 데이터를 실시간으로 얻을 수 있는 파이프라인
이후 Ingestion Bucket에서는 SQS로 메시지를 넣거나 혹은 Athena가데이터를 Pull 해간다
이후 다른 버킷으로 보고, 정리, 분석을 위해 저장된다
보고 버킷에는 분석된 데이터가 포함되어 있어 QuickSight, Redshift 등의 보고 도구에서 사용
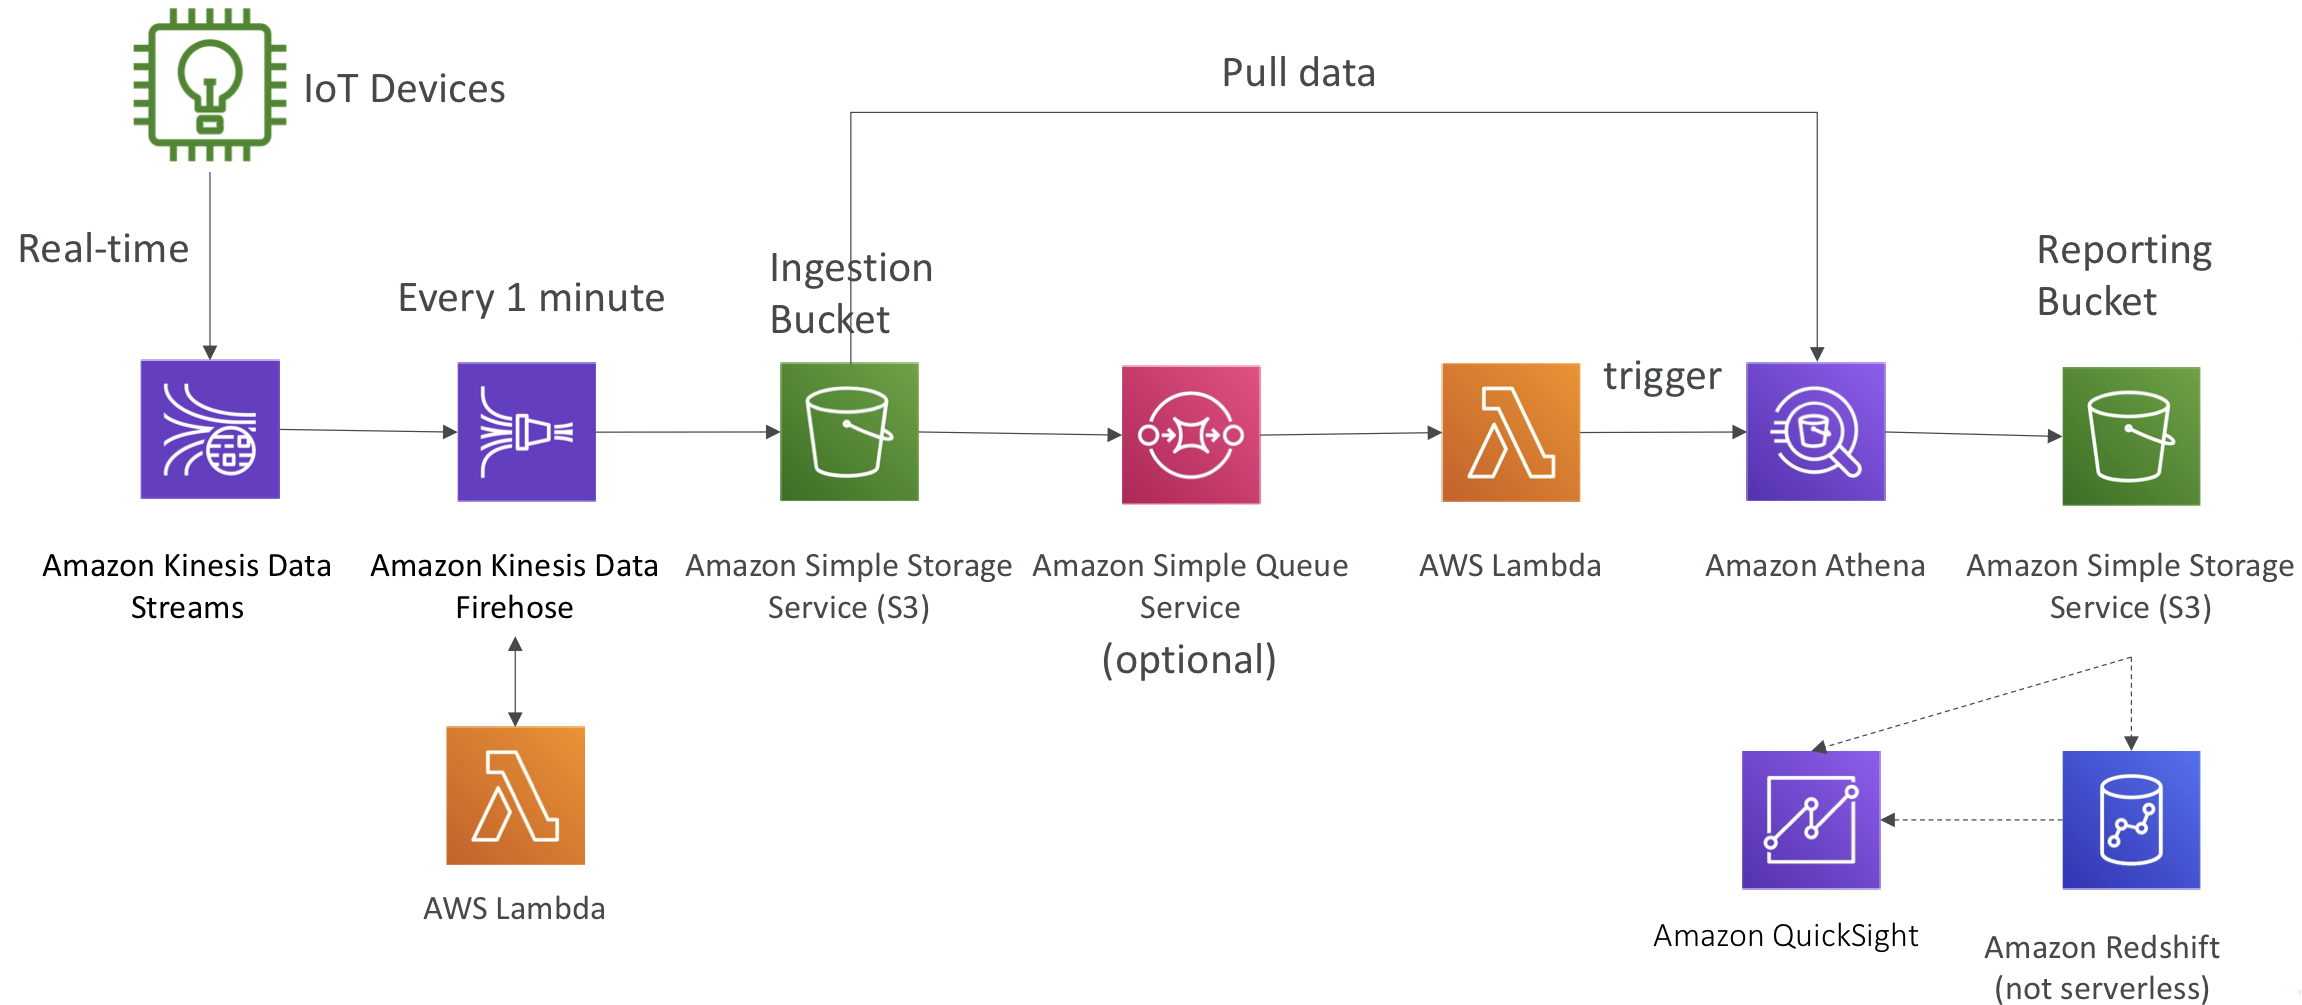
- IoT Core는 여러 IoT 장치에서 데이터 수집을 허용
- Kinesis는 실시간 데이터 수집에 효과적
- Kinesis Firehose는 실시간에 가깝게 s3로 데이터 운반을 돕는다
- Lambda는 Firehose를 도와 데이터를 변형
- s3가 SQS, SNS, Lambda로 알림을 실행
- SQS를 구독하거나 S3를 람다에 직접 연결하기도 한다
- Athena는 서버리스 SQL 서비스로 결과를 s3에 직접 저장
- 보고 버킷은 분석된 데이터를 보관하여 QuickSight, Redshift 등의 보고 도구를 사용해 추가 분석할 수 있다