[LLM] Transformer의 토큰 생성과 구조화 출력
Transformer Explainer로 토큰·임베딩·Attention·샘플링의 흐름을 살펴보고, 구조화 출력과 사실 검증의 역할을 구분합니다.
개요
LLM은 입력 문장을 토큰으로 나누고 문맥을 반영한 벡터를 계산한 뒤 다음 토큰을 선택합니다.
이 과정을 반복하면서 문장을 만듭니다.
모델의 응답을 다른 프로그램에서 사용하려면 생성 과정뿐 아니라 출력 형식과 내용의 정확성도 구분해야 합니다.
Transformer Explainer의 GPT-2 small을 기준으로 입력부터 토큰 선택까지 살펴보겠습니다.
이어 vLLM의 구조화 출력과 로그 요약 예시를 통해 프로그램에 전달할 결과의 기준을 정리하겠습니다.
토큰 ID와 임베딩
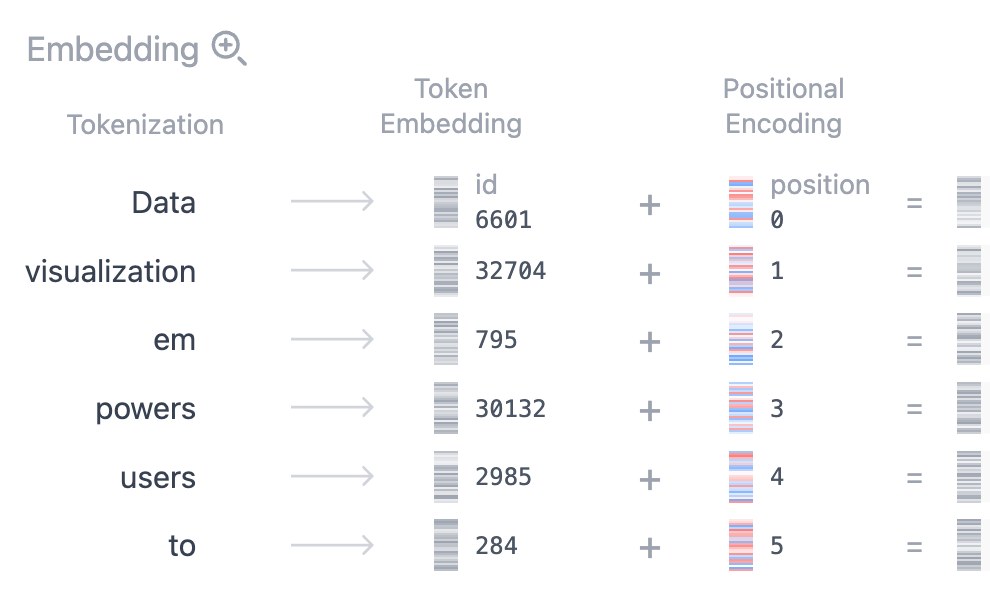
토큰 ID는 토큰을 구분하는 번호입니다.
모델은 이 번호로 학습된 임베딩 표에서 벡터를 찾아 계산에 사용합니다.
ID가 가까운 토큰이라고 의미도 가까운 것은 아닙니다.
그림에서 empowers는 em과 powers로 나뉩니다.
토큰은 단어 전체일 수도 있고 단어의 일부일 수도 있습니다.
GPT-2는 토큰의 임베딩 벡터에 위치 벡터를 더합니다.
같은 토큰들이 있어도 순서에 따라 문장의 의미가 달라지기 때문입니다.
이 벡터가 Transformer block의 입력이 됩니다.
Attention과 마스크
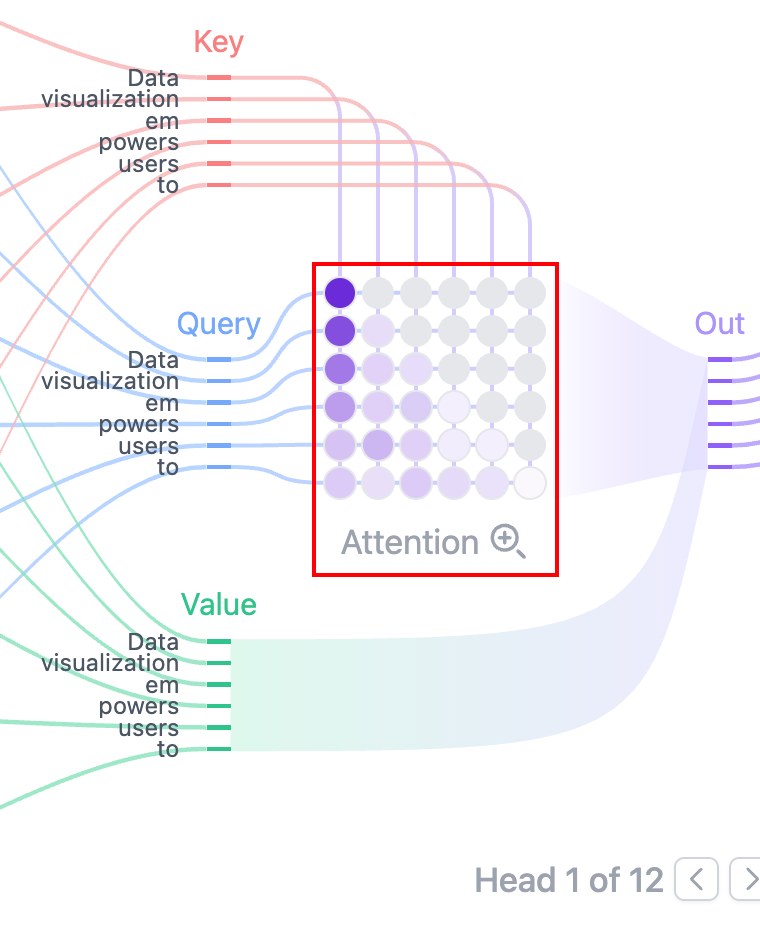
Self-Attention은 각 토큰이 다른 위치의 정보를 얼마나 참고할지 계산합니다.
각 토큰의 벡터에서 Query·Key·Value를 만들고 Query와 Key의 비교로 구한 비율에 따라 Value를 섞습니다.
그 결과 각 위치의 벡터에 문맥이 반영됩니다.
그림의 행은 Query 위치, 열은 Key 위치입니다.
오른쪽 위 회색 영역은 뒤에 오는 토큰을 참고하지 못하도록 막은 causal mask입니다.
첫 토큰 Data는 자기 자신만 참고하고 마지막 토큰 to는 앞선 토큰과 자기 자신을 참고할 수 있습니다.
보라색의 진하기는 참고 비율을 나타냅니다.
연한 보라색은 비율이 낮다는 뜻이고 회색은 마스크로 제외된 위치입니다.
Multi-head와 Transformer block
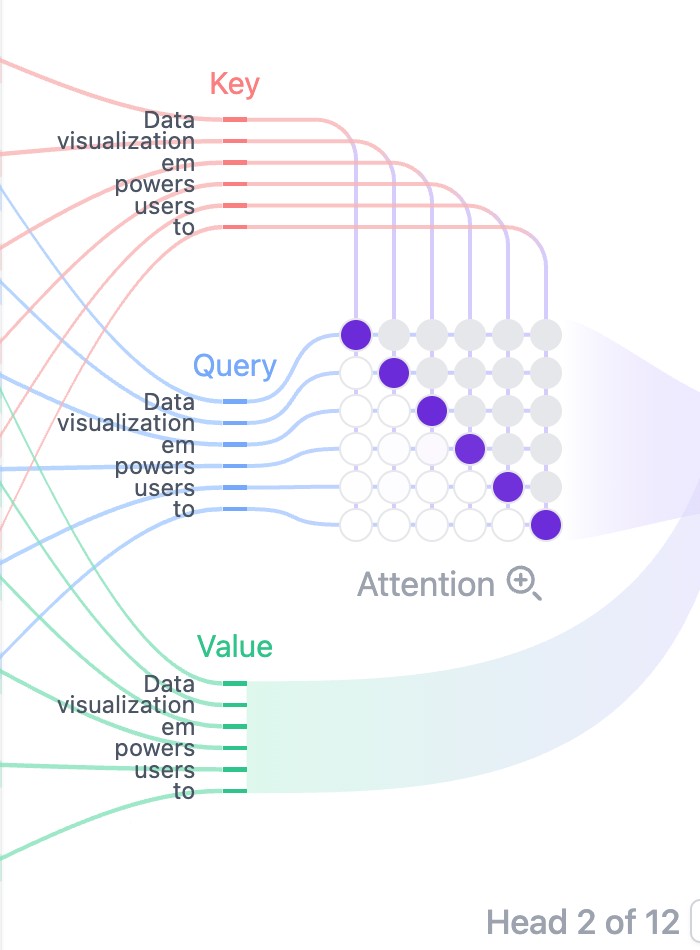
같은 입력도 head마다 attention 분포가 다릅니다.
각 head가 서로 다른 학습된 변환으로 Query·Key·Value를 만들기 때문입니다.
위 Head 2는 대각선이 진해 각 토큰이 자기 위치에 큰 비중을 두고 있습니다. 이 입력에서 나타난 분포이며 모든 입력에서 같은 역할을 한다는 뜻은 아닙니다.
GPT-2 small은 블록 12개로 구성되며 각 블록에 attention head 12개가 있습니다.
head들은 한 블록 안에서 병렬로 계산하고 블록들은 앞 블록의 결과를 받아 순서대로 가공합니다.
같은 번호의 head라도 블록이 다르면 가중치와 입력 벡터가 다릅니다.
각 head의 결과 벡터를 이어 붙여 선형 변환하고 residual 연결과 LayerNorm을 거쳐 MLP에 전달합니다.
Attention이 토큰 사이의 정보를 섞는다면 MLP는 각 위치의 벡터를 개별적으로 가공합니다.
블록을 통과하는 동안에는 새 토큰이 생성되는 것이 아니라 기존 위치의 벡터가 바뀝니다.
다음 토큰의 선택
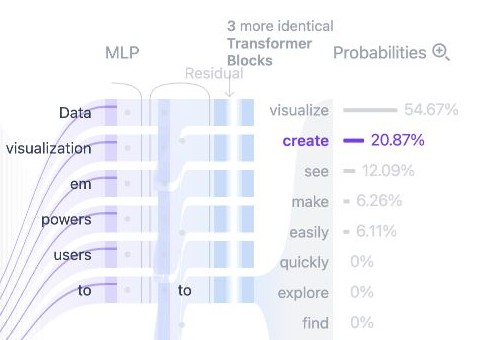
모든 블록을 통과한 마지막 위치의 벡터는 앞선 문맥을 반영합니다.
최종 LayerNorm과 출력층을 거치면 어휘 목록의 각 토큰에 대한 점수인 logit이 나옵니다.
생성 설정을 적용하고 확률로 변환한 뒤 다음 토큰을 선택합니다.
그림은 temperature 0.8, top-k 5를 적용한 결과입니다.
visualize의 표시 확률은 약 54.67%지만 선택된 토큰은 약 20.87%인 create입니다.
샘플링에서는 가장 높은 확률의 후보가 항상 선택되지는 않습니다.
- Greedy는 가장 높은 점수의 토큰을 선택합니다.
- Sampling은 허용된 후보의 확률에 따라 토큰을 선택합니다.
- Temperature는 후보 확률의 분포를 조정하고 top-k는 선택 후보를 상위 k개로 제한합니다.
선택한 토큰을 문장 뒤에 붙이면 다음 토큰을 생성하는 과정이 이어집니다.
따라서 같은 입력이라도 선택 설정에 따라 다른 문장이 나올 수 있습니다.
화면과 모델 구조는 Transformer Explainer에서 확인할 수 있습니다.
프로그램에 전달할 출력 형식
문장을 읽는 사람은 표현이 조금 달라도 뜻을 이해할 수 있습니다.
하지만 다음 프로그램이 JSON의 특정 필드를 읽는다면 형식이 달라질 때 처리가 실패할 수 있습니다.
제약 디코딩은 다음 토큰을 선택할 때 JSON Schema나 문법에 맞지 않는 후보를 제외합니다.
Transformer block 내부에 검증 레이어를 추가하는 방식이 아니라 생성 과정의 토큰 선택을 제한하는 방식입니다.
vLLM은 오프라인 추론에서 StructuredOutputsParams(json=schema)를 SamplingParams에 넣어 사용합니다.
실행 중인 서버를 API로 호출할 때는 response_format 등으로 스키마를 전달합니다.
여기서 스키마는 실제 답변이 아니라 필드 이름·자료형·허용 값과 같은 출력 규칙입니다.
vLLM Structured Outputs에 두 방식의 예제가 있습니다.
형식을 제한해도 내용의 정확성까지 보장되지는 않습니다.
label을 normal과 attack 중 하나로 제한해도 잘못된 분류는 가능합니다.
받는 프로그램은 응답 완료 여부와 형식을 확인하고 업무에 필요한 정확성은 별도로 평가해야 합니다.
Jev처럼 판단값과 확률을 출력하는 모델도 있습니다.
TypeSafe는 Jev가 RLCD로 판단과 확률 보정을 학습한다고 설명합니다.
이는 추론 중 JSON 형식을 제한하는 기능과 구분되며 공개 자료에는 내부 블록·head의 상세 구성이 제시되어 있지 않습니다.
Jev AI primer
로그 요약의 사실 기준
아래 로그 정보를 요약한다고 가정해 보겠습니다.
10:00~10:01 사이 같은 IP에서 로그인 20회 실패. 이후 로그인 1회 성공.
이 입력에서는 실패 횟수와 시간 범위, 동일 IP, 이후 성공 기록을 확인할 수 있습니다.
공격 여부나 계정 탈취 여부는 이 정보만으로 확정할 수 없습니다.
요약 결과의 예시는 다음과 같습니다.
{
  "summary": "10:00~10:01 사이 동일 IP에서 로그인 20회 실패가 기록됐고, 이후 로그인 1회 성공이 기록됐다."
}
출력은 입력의 횟수·시간·순서를 보존해야 합니다.
성공 시각은 주어지지 않았으므로 임의로 붙이지 않고 동일 IP를 동일 계정이나 동일 인물로 바꾸어 해석하지 않습니다.
JSON Schema는 summary라는 문자열 필드를 갖추도록 제한할 수 있습니다.
그 안의 문장이 원본에 없는 사실을 덧붙였는지는 별도의 검증 대상입니다.
프로그램이 읽을 수 있는 형식과 업무에 사용할 수 있는 내용은 각각 확인해야 합니다.